

Loyiha: Matn tahlilçisi
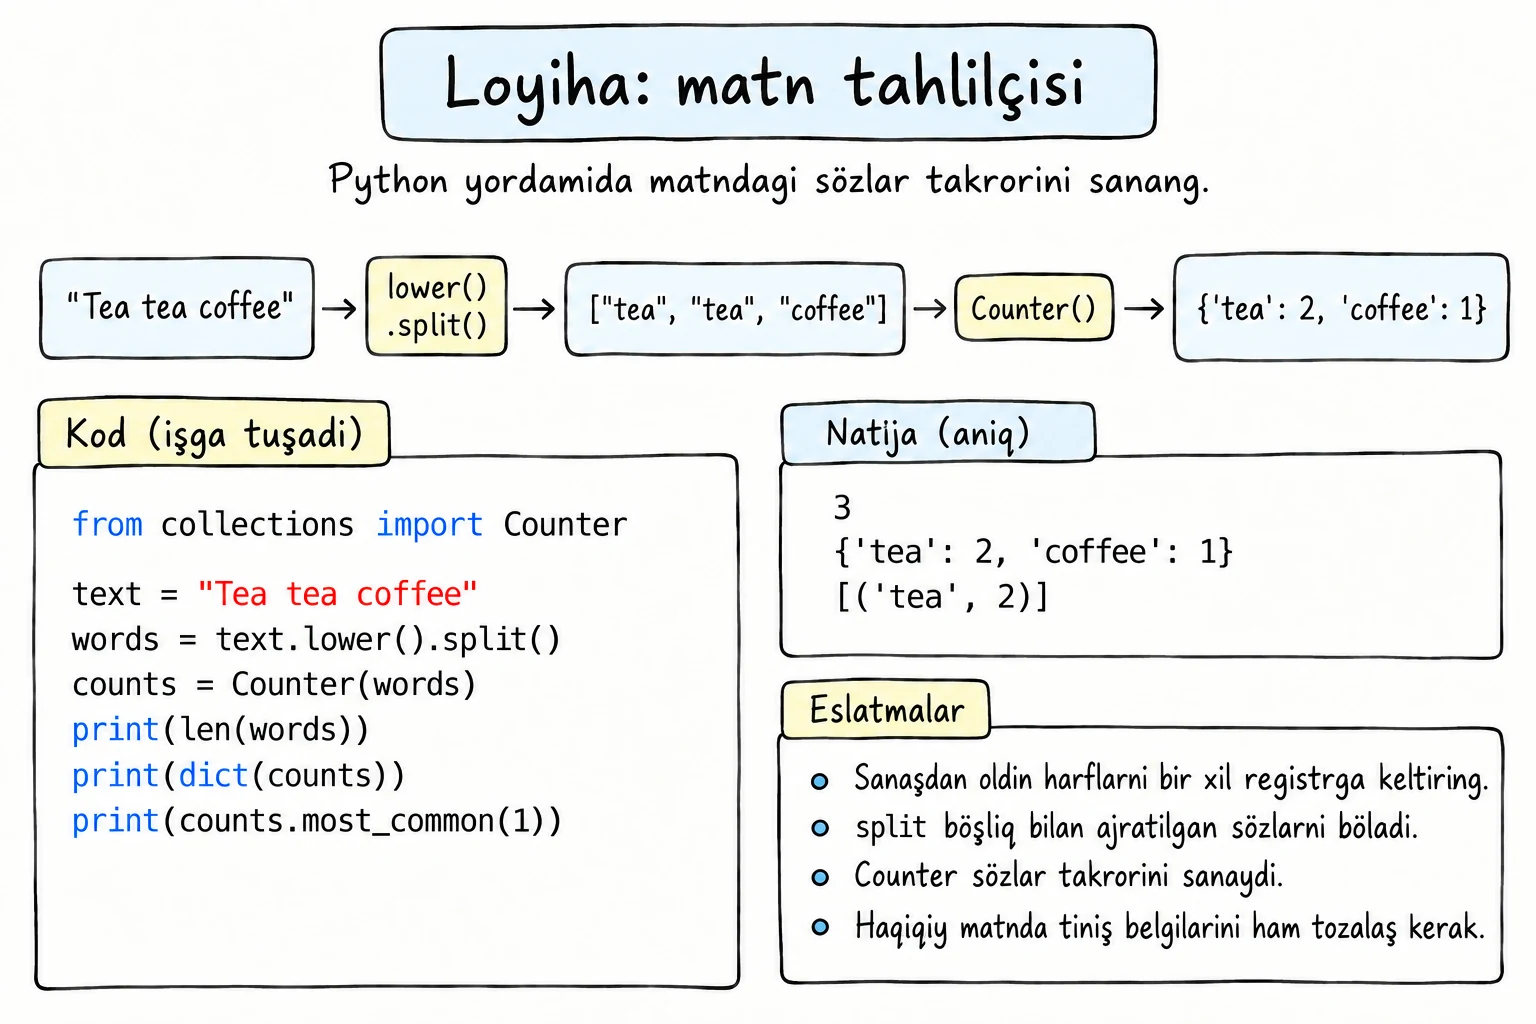
Nimalarni örganasiz
- Loyihani kiçik, testlaş oson funksiyalar töplami sifatida qanday rejalaş
- Fayllar, generatorlar, regex va
collections.Counterni bitta dasturda qanday birlaştiriş - Natijalarni dataclass ga qanday yiğiş va ularni JSON hamda matnli hisobot sifatida saqlaş
- Dasturning sof qismlarini oddiy test funksiyalari bilan qanday testlaş
- Haqiqiy matn muammolarini qanday hal qiliş: harf registri, tiniş belgilari, kodlaş (encoding), özbekça harflar va böş fayllar
Nega bu muhim
Söz hisoblagiçlari, öqiluvçanlikni tekşiruvçilar, SEO vositalari, spam filtrlari va qidiruv tizimlari bir xil asosiy işdan boşlanadi: matnni öqiş, uni sözlar va gaplarga böliş, narsalarni sanaş va andozalarni topiş. Bu loyihada siz noldan öz matn tahlilçingizni yaratasiz. U bir öltirişda tugatiş mumkin bölgan darajada kiçik, lekin oxirgi bir neçta moduldagi deyarli hamma narsadan foydalanadi va alohida könikmalar haqiqiy dasturga qanday birlaşişini körsatadi.
Maqsad va imkoniyatlar
Dasturingiz matn faylini öqiydi va mana bunday hisobot tuzadi:
cafe.txt uçun hisobot
=====================
Belgilar:          665 (böşliqsiz 572)
Sözlar:            85
Gaplar:            10
...
Eng köp uçraydigan sözlar:
  çoyxona      4
  çoyni        2
...
Emaillar: aziza@ipakyoli.uz, jobs@ipakyoli.uz
Imkoniyatlar:
| Imkoniyat | Foydalaniladigan vositalar |
|---|---|
| Matn faylini xavfsiz öqiş | pathlib, encoding="utf-8" |
| Belgilar, sözlar, gaplar va xatboşilarni sanaş | regex, generatorlar |
| Yordamçi sözlarni hisobga olmagan holda eng köp uçraydigan sözlar | Counter, töplamlar |
| Sözlar va gaplarning örtaça uzunligi | funksiyalar, himoya şartlari |
| Eng uzun sözlar | kalitli sorted |
| Öqiş vaqtini taxminlaş | oddiy matematika |
| Emaillar, URL lar va sonlarni ajratib oliş | re andozalari |
| JSON va matnli hisobotni saqlaş | json, dataclasses.asdict |
| Mantiqni tekşiriş | assert li test funksiyalari |
Loyihalaş
Kod yozişdan oldin funksiyalarni va maʼlumotlar ular orasida qanday oqib ötişini röyxatga oling. Har bir funksiya bitta iş qiladi va ularning köpçiligi sof (pure): ular matn yoki sözlarni olib, natija qaytaradi, heç narsa çiqarmaydi va fayllarga tegmaydi. Sof funksiyalarni testlaş oson.
cafe.txt
read_text(path)text(str)
remove_links(text)
iter_words(text)generatorwords(list)top_words(words)longest_words(words)reading_time(n)
count_sentences(text)
count_paragraphs(text)
extract(text)emails, urls, numbers
analyze(text)TextStats(dataclass)
format_report(stats)report.txt
json.dumps(asdict(stats))report.json
Faqat read_text, save_reports va main fayllar yoki ekran bilan işlaydi. Qolgan hamma narsa sof.
1-qadam: Namuna fayl yaratiş va uni öqiş
Haqiqiy foydalanuvçi öz faylini beradi. Hamma narsa işga tuşa olişi uçun dastur avval namuna matnni yozadi. Matnni öqiş va yozişda doim encoding="utf-8" ni körsating: özbekça ö, ğ, ş, ç va ʼ harflari boşqa kodlaşlarda buzilib ketişi mumkin.
from pathlib import Path

SAMPLE_TEXT = """\
"Ipak yöli" çoyxonasi 2019-yilda Samarqandda oçilgan. U 12 ta stol,
kiçkina oşxona va katta ğoya bilan boşlangan: kök çoyni buvilarimiz damlaganidek damlaş.
Bugun çoyxona har kuni 350 ga yaqin mehmonni kutib oladi!

Çoyxona egasi Aziza har bir xabarga özi javob beradi. Unga aziza@ipakyoli.uz
manziliga yozing yoki menyuni köriş uçun https://ipakyoli.uz/menyu sahifasiga kiring.
Bu yerdagi çoy rostdan ham Samarqanddagi eng yaxşi çoymi? Köp mehmonlar şunday deb öylaydi.

Kelasi yil çoyxona jamoasi Buxoroda ikkinçi çoyxona oçmoqçi. Byudjet 450000000 söm,
mehmonlar esa xuddi şu taʼmli çoyni kutişi mumkin. Iş böyiça savollarni jobs@ipakyoli.uz manziliga yuboring.
"""
Path("cafe.txt").write_text(SAMPLE_TEXT, encoding="utf-8")

def read_text(path):
    return Path(path).read_text(encoding="utf-8")

text = read_text("cafe.txt")
print(text[:60])
print("Belgilar:", len(text))
print("Böşmi?", not text.strip())"Ipak yöli" çoyxonasi 2019-yilda Samarqandda oçilgan. U 12 t
Belgilar: 665
Böşmi? Falsenot text.strip() fayl böş yoki faqat böşliq va yangi qatorlardan iborat bölganda True böladi. Bu tekşiruvni main() da işlatasiz.
2-qadam: Matnni sözlarga böliş
Birinçi xayolga keladigan text.split() usuli yetarli emas:
text = "Çoy, çoy va ÇOY! Bu çoy yaxşimi? Maʼlumot aniq."
print(text.split())['Çoy,', 'çoy', 'va', 'ÇOY!', 'Bu', 'çoy', 'yaxşimi?', 'Maʼlumot', 'aniq.']"Çoy,", "çoy" va "ÇOY!" uç xil söz sifatida sanalardi. Matnni kiçik harflarga özgartiriş va faqat harflarni qoldiriş kerak. Regex ikkala işni ham bajaradi. [a-zöğşç]+(?:ʼ[a-zöğşç]+)* andozasi "harflar, ixtiyoriy ravişda tutuq belgisi va yana harflar" degani, şuning uçun maʼlumot bitta söz bölib qoladi. Özbekça harflarni sinfga qöşiş muhim: oddiy [a-z]+ çoy dan faqat oy ni ajratib olardi. Bu andoza ham umumiy söz andozasi emas: é kabi harflar yoki boşqa tutuq belgilari (‘, ') uçun uni kengaytiriş kerak böladi. Generator sözlarni bittadan beradi:
import re

WORD_RE = re.compile(r"[a-zöğşç]+(?:ʼ[a-zöğşç]+)*")

def iter_words(text):
    for match in WORD_RE.finditer(text.lower()):
        yield match.group()

text = "Çoy, çoy va ÇOY! Bu çoy yaxşimi? Maʼlumot aniq."
print(list(iter_words(text)))['çoy', 'çoy', 'va', 'çoy', 'bu', 'çoy', 'yaxşimi', 'maʼlumot', 'aniq']Yana bitta tuzoq bor. Emaillar va URL larda ham harflar bor, şuning uçun aziza@ipakyoli.uz aziza, ipakyoli, uz "sözlariga" aylanib qolardi. Sözlarni sanaşdan oldin ularni olib taşlang:
import re

WORD_RE = re.compile(r"[a-zöğşç]+(?:ʼ[a-zöğşç]+)*")
EMAIL_RE = re.compile(r"[\w.+-]+@[\w-]+(?:\.[\w-]+)*\.[a-z]{2,}", re.IGNORECASE)
URL_RE = re.compile(r"https?://[^\s,]+[^\s,.]")

def remove_links(text):
    text = URL_RE.sub(" ", text)
    return EMAIL_RE.sub(" ", text)

def iter_words(text):
    for match in WORD_RE.finditer(text.lower()):
        yield match.group()

line = "Bugun aziza@ipakyoli.uz ga yozing yoki https://ipakyoli.uz/menyu sahifasiga kiring."
print(list(iter_words(line)))
print(list(iter_words(remove_links(line))))['bugun', 'aziza', 'ipakyoli', 'uz', 'ga', 'yozing', 'yoki', 'https', 'ipakyoli', 'uz', 'menyu', 'sahifasiga', 'kiring']
['bugun', 'ga', 'yozing', 'yoki', 'sahifasiga', 'kiring']URL andozasi [^\s,.] bilan tugaydi, şuning uçun havoladan keyin kelgan nuqta unga kirmaydi.
Nega generator?
iter_words özi heç qaçon röyxat qurmaydi. Bu loyihada unga list() ni qöllaymiz, çunki sözlar bizga bir neçta marta kerak, lekin xuddi şu funksiya ulkan faylni qatorma-qator öqiyotganda sözlarni töğridan-töğri Counter ga uzatişi ham mumkin.
3-qadam: Belgilar, gaplar va xatboşilar
Gap ., ! yoki ? (balki ?! kabi bir neçtasi) va undan keyin keladigan böşliq yoki matn oxiri bilan tugaydi. Xatboşilar böş qator bilan ajratiladi.
import re

SENTENCE_END_RE = re.compile(r"[.!?]+(?:\s|$)")

def count_sentences(text):
    return len(SENTENCE_END_RE.findall(text.strip()))

def count_paragraphs(text):
    return len([p for p in re.split(r"\n\s*\n", text) if p.strip()])

text = """Buxorodan salom! Bugun issiqmi?! Ha.

3.5 soatlik çoy sayohati uçun ipakyoli.uz saytiga kiring.


Tamom."""

print("Belgilar:", len(text))
print("Böşliqsiz:", len(re.sub(r"\s", "", text)))
print("Gaplar:", count_sentences(text))
print("Xatboşilar:", count_paragraphs(text))Belgilar: 104
Böşliqsiz: 88
Gaplar: 5
Xatboşilar: 3Tiniş belgisidan keyin böşliq talab qilinişi ipakyoli.uz va 3.5 gapni tugatmasligini bildiradi. Dr. Karimov kabi qisqartmalar baribir notöğri sanaladi. Gaplarni mukammal aniqlaş kutilmaganda qiyin, bu loyiha uçun esa "yetarliça yaxşi" natija kifoya.
4-qadam: Eng köp uçraydigan va eng uzun sözlar
Counter sözlarni sanaydi, yordamçi sözlar (stop words) töplami esa aks holda doim birinçi örinni egallaydigan zerikarli sözlarni ("va", "bu", "ham") olib taşlaydi:
from collections import Counter

STOP_WORDS = {"va", "ham", "eng", "bu", "bilan", "uçun", "esa"}

def top_words(words, n=5, stop_words=STOP_WORDS):
    counts = Counter(w for w in words if w not in stop_words)
    return counts.most_common(n)

def longest_words(words, n=3):
    unique = set(words)
    return sorted(unique, key=lambda w: (-len(w), w))[:n]

words = ["çoy", "samarqandda", "va", "çoy", "buxoroda", "ham", "bu", "çoy",
         "va", "eng", "yaxşi", "çoy", "özbekistonda", "ham", "va"]

print(top_words(words))
print(top_words(words, n=2, stop_words=set()))
print(longest_words(words))[('çoy', 4), ('samarqandda', 1), ('buxoroda', 1), ('yaxşi', 1), ('özbekistonda', 1)]
[('çoy', 4), ('va', 3)]
['özbekistonda', 'samarqandda', 'buxoroda']Bu yerda ikki narsa muhim:
stop_wordsstandart qiymatli parametr, şuning uçun testlar va boşqa foydalanuvçilar öz töplamini bera oladi.(-len(w), w)saralaş kaliti avval uzunlik böyiça (eng uzuni birinçi), keyin alifbo böyiça saralaydi. Ikkinçi qismsiz bir xil uzunlikdagi sözlar har işga tuşirişda boşqa tartibda çiqişi mumkin, çunki töplamlarda qatʼiy tartib yöq. Barqaror natija testlaşni mumkin qiladi.
5-qadam: Örtaça qiymatlar va öqiş vaqti
Örtaça qiymat sonni miqdorga böliş orqali topiladi, miqdor esa nol bölişi mumkin. Bundan himoyalaning, aks holda böş fayl dasturni qulatadi:
WORDS_PER_MINUTE = 200

def average(total, count):
    return round(total / count, 2) if count else 0.0

def reading_time(word_count, wpm=WORDS_PER_MINUTE):
    return round(word_count / wpm, 1)

words = ["kök", "çoy", "samarqandda"]
print("Ört. söz uzunligi:", average(sum(map(len, words)), len(words)))
print("Ört. gap uzunligi:", average(len(words), 1))
print("Böş matn:", average(0, 0))
print("1,500 söz uçun öqiş vaqti:", reading_time(1500), "daqiqa")Ört. söz uzunligi: 5.67
Ört. gap uzunligi: 3.0
Böş matn: 0.0
1,500 söz uçun öqiş vaqti: 7.5 daqiqaKatta yoşli odam daqiqasiga taxminan 200-250 söz öqiydi. Bu sonni nomlangan konstantada saqlaş uni özgartirişni osonlaştiradi.
6-qadam: Emaillar, URL lar va sonlarni ajratib oliş
Email va URL andozalari 2-qadamdagilar bilan bir xil, NUMBER_RE esa butun sonlarni va 3.5 kabi önlik sonlarni topadi:
import re

EMAIL_RE = re.compile(r"[\w.+-]+@[\w-]+(?:\.[\w-]+)*\.[a-z]{2,}", re.IGNORECASE)
URL_RE = re.compile(r"https?://[^\s,]+[^\s,.]")
NUMBER_RE = re.compile(r"\b\d+(?:\.\d+)?\b")

def remove_links(text):
    text = URL_RE.sub(" ", text)
    return EMAIL_RE.sub(" ", text)

def extract(text):
    urls = URL_RE.findall(text)
    emails = EMAIL_RE.findall(text)
    numbers = NUMBER_RE.findall(remove_links(text))
    return emails, urls, numbers

text = "2 ta döstingizni çaqiring, 45000 söm yoki 3.5 USD tölang. info@tour2026.uz ga yozing, https://tour2026.uz/narxlar sahifasini köring."
emails, urls, numbers = extract(text)
print(emails)
print(urls)
print(numbers)['info@tour2026.uz']
['https://tour2026.uz/narxlar']
['2', '45000', '3.5']Sonlar havolalar olib taşlangan matndan qidiriladi, aks holda domen nomi içidagi 2026 son sifatida körsatilardi.
7-qadam: Natijalarni dataclass ga yiğiş
13 ta qiymat qaytaradigan funksiyaga aniq idiş kerak. Dataclass (Dataclasslar darsidan) har bir qiymatga nom beradi, çiroyli repr yaratadi va asdict() orqali qöşimça kodsiz luğatga aylantiriş imkonini beradi:
from dataclasses import dataclass, asdict

@dataclass
class TextStats:
    words: int
    sentences: int
    top_words: list

stats = TextStats(words=85, sentences=10, top_words=[("çoyxona", 4), ("çoyni", 2)])
print(stats)
print(stats.words)
print(asdict(stats))TextStats(words=85, sentences=10, top_words=[('çoyxona', 4), ('çoyni', 2)])
85
{'words': 85, 'sentences': 10, 'top_words': [('çoyxona', 4), ('çoyni', 2)]}Keyin analyze(text) funksiyasi barça yordamçi funksiyalarni çaqiradi va bitta TextStats ni töldiradi. Uni quyidagi töliq dasturda körasiz.
8-qadam: Hisobotlarni yoziş
Matnli hisobot satr qaytaradigan sof funksiya tomonidan tuziladi. Saqlaş esa alohida, juda kiçik funksiya. Şunday qilib, formatlaşni fayl yaratmasdan testlay olasiz. Özbekça harflar JSON faylda \u00f6 kabi kodlar körinişida emas, öz holida saqlanişi uçun ensure_ascii=False dan foydalanamiz:
import json
from dataclasses import dataclass, asdict
from pathlib import Path

@dataclass
class TextStats:
    words: int
    sentences: int
    top_words: list

def format_report(stats, title="Matn hisoboti"):
    lines = [title, "=" * len(title), f"Sözlar: {stats.words}", f"Gaplar: {stats.sentences}", "Eng köp uçraydigan sözlar:"]
    for word, count in stats.top_words:
        lines.append(f"  {word:<10} {count}")
    return "\n".join(lines)

stats = TextStats(words=85, sentences=10, top_words=[("çoyxona", 4), ("çoyni", 2)])

Path("report.txt").write_text(format_report(stats) + "\n", encoding="utf-8")
Path("report.json").write_text(json.dumps(asdict(stats), indent=2, ensure_ascii=False), encoding="utf-8")

print(Path("report.txt").read_text(encoding="utf-8"))
print(Path("report.json").read_text(encoding="utf-8"))Matn hisoboti
=============
Sözlar: 85
Gaplar: 10
Eng köp uçraydigan sözlar:
çoyxona 4
çoyni 2
{
"words": 85,
"sentences": 10,
"top_words": [
[
"çoyxona",
4
],
[
"çoyni",
2
]
]
}JSON da kortejlar yöq, şuning uçun ("çoyxona", 4) ["çoyxona", 4] röyxati sifatida saqlanadi. Faylni qayta yuklaganingizda röyxatlar olasiz.
Töliq dastur
Mana hammasi birgalikda. Uni text_analyzer.py ga nusxalang va işga tuşiring. Öz faylingizni tahlil qiliş uçun main() dagi yölni özgartiring va namunani yozadigan qatorni öçiring.
import json
import re
from collections import Counter
from dataclasses import dataclass, asdict
from pathlib import Path

SAMPLE_TEXT = """\
"Ipak yöli" çoyxonasi 2019-yilda Samarqandda oçilgan. U 12 ta stol,
kiçkina oşxona va katta ğoya bilan boşlangan: kök çoyni buvilarimiz damlaganidek damlaş.
Bugun çoyxona har kuni 350 ga yaqin mehmonni kutib oladi!

Çoyxona egasi Aziza har bir xabarga özi javob beradi. Unga aziza@ipakyoli.uz
manziliga yozing yoki menyuni köriş uçun https://ipakyoli.uz/menyu sahifasiga kiring.
Bu yerdagi çoy rostdan ham Samarqanddagi eng yaxşi çoymi? Köp mehmonlar şunday deb öylaydi.

Kelasi yil çoyxona jamoasi Buxoroda ikkinçi çoyxona oçmoqçi. Byudjet 450000000 söm,
mehmonlar esa xuddi şu taʼmli çoyni kutişi mumkin. Iş böyiça savollarni jobs@ipakyoli.uz manziliga yuboring.
"""

STOP_WORDS = {
    "u", "ta", "va", "bilan", "har", "ga", "bir", "özi", "unga", "yoki", "uçun",
    "bu", "ham", "eng", "deb", "esa", "şu", "mumkin", "köp", "kuni", "bugun",
    "yil", "kelasi", "şunday", "xuddi", "manziliga",
}

WORDS_PER_MINUTE = 200

WORD_RE = re.compile(r"[a-zöğşç]+(?:ʼ[a-zöğşç]+)*")
SENTENCE_END_RE = re.compile(r"[.!?]+(?:\s|$)")
EMAIL_RE = re.compile(r"[\w.+-]+@[\w-]+(?:\.[\w-]+)*\.[a-z]{2,}", re.IGNORECASE)
URL_RE = re.compile(r"https?://[^\s,]+[^\s,.]")
NUMBER_RE = re.compile(r"\b\d+(?:\.\d+)?\b")


@dataclass
class TextStats:
    characters: int
    characters_no_spaces: int
    words: int
    sentences: int
    paragraphs: int
    average_word_length: float
    average_sentence_length: float
    reading_time_minutes: float
    top_words: list
    longest_words: list
    emails: list
    urls: list
    numbers: list


def read_text(path):
    return Path(path).read_text(encoding="utf-8")


def remove_links(text):
    text = URL_RE.sub(" ", text)
    return EMAIL_RE.sub(" ", text)


def iter_words(text):
    for match in WORD_RE.finditer(text.lower()):
        yield match.group()


def count_sentences(text):
    return len(SENTENCE_END_RE.findall(text.strip()))


def count_paragraphs(text):
    return len([p for p in re.split(r"\n\s*\n", text) if p.strip()])


def top_words(words, n=5, stop_words=STOP_WORDS):
    counts = Counter(w for w in words if w not in stop_words)
    return counts.most_common(n)


def longest_words(words, n=3):
    unique = set(words)
    return sorted(unique, key=lambda w: (-len(w), w))[:n]


def reading_time(word_count, wpm=WORDS_PER_MINUTE):
    return round(word_count / wpm, 1)


def extract(text):
    urls = URL_RE.findall(text)
    emails = EMAIL_RE.findall(text)
    numbers = NUMBER_RE.findall(remove_links(text))
    return emails, urls, numbers


def analyze(text):
    words = list(iter_words(remove_links(text)))
    sentences = count_sentences(text)
    emails, urls, numbers = extract(text)
    word_count = len(words)
    return TextStats(
        characters=len(text),
        characters_no_spaces=len(re.sub(r"\s", "", text)),
        words=word_count,
        sentences=sentences,
        paragraphs=count_paragraphs(text),
        average_word_length=round(sum(map(len, words)) / word_count, 2) if words else 0.0,
        average_sentence_length=round(word_count / sentences, 2) if sentences else 0.0,
        reading_time_minutes=reading_time(word_count),
        top_words=top_words(words),
        longest_words=longest_words(words),
        emails=emails,
        urls=urls,
        numbers=numbers,
    )


def format_report(stats, title="Matn hisoboti"):
    lines = [
        title,
        "=" * len(title),
        f"Belgilar:          {stats.characters} (böşliqsiz {stats.characters_no_spaces})",
        f"Sözlar:            {stats.words}",
        f"Gaplar:            {stats.sentences}",
        f"Xatboşilar:        {stats.paragraphs}",
        f"Ört. söz uzunligi: {stats.average_word_length}",
        f"Ört. gap uzunligi: {stats.average_sentence_length} söz",
        f"Öqiş vaqti:        {stats.reading_time_minutes} daqiqa",
        "",
        "Eng köp uçraydigan sözlar:",
    ]
    for word, count in stats.top_words:
        lines.append(f"  {word:<12} {count}")
    lines.append("Eng uzun sözlar: " + ", ".join(stats.longest_words))
    lines.append("Emaillar: " + (", ".join(stats.emails) or "-"))
    lines.append("URLlar:   " + (", ".join(stats.urls) or "-"))
    lines.append("Sonlar:   " + (", ".join(stats.numbers) or "-"))
    return "\n".join(lines)


def save_reports(stats, json_path, text_path):
    Path(json_path).write_text(json.dumps(asdict(stats), indent=2, ensure_ascii=False), encoding="utf-8")
    Path(text_path).write_text(format_report(stats) + "\n", encoding="utf-8")


def main():
    Path("cafe.txt").write_text(SAMPLE_TEXT, encoding="utf-8")

    text = read_text("cafe.txt")
    if not text.strip():
        print("Fayl böş, tahlil qiladigan narsa yöq.")
        return

    stats = analyze(text)
    print(format_report(stats, "cafe.txt uçun hisobot"))

    save_reports(stats, "report.json", "report.txt")
    loaded = json.loads(Path("report.json").read_text(encoding="utf-8"))
    print()
    print("report.json saqlandi, kalitlari:", ", ".join(list(loaded)[:4]), "...")
    print("report.txt saqlandi:", Path("report.txt").stat().st_size, "bayt")


if __name__ == "__main__":
main()cafe.txt uçun hisobot
=====================
Belgilar: 665 (böşliqsiz 572)
Sözlar: 85
Gaplar: 10
Xatboşilar: 3
Ört. söz uzunligi: 5.65
Ört. gap uzunligi: 8.5 söz
Öqiş vaqti: 0.4 daqiqa
Eng köp uçraydigan sözlar:
çoyxona 4
çoyni 2
mehmonlar 2
ipak 1
yöli 1
Eng uzun sözlar: samarqanddagi, damlaganidek, buvilarimiz
Emaillar: aziza@ipakyoli.uz, jobs@ipakyoli.uz
URLlar: https://ipakyoli.uz/menyu
Sonlar: 2019, 12, 350, 450000000
report.json saqlandi, kalitlari: characters, characters_no_spaces, words, sentences ...
report.txt saqlandi: 518 baytTuzilişga eʼtibor bering: yuqorida konstantalar va kompilyatsiya qilingan andozalar, örtada kiçik sof funksiyalar, barça kiritiş/çiqariş esa read_text(), save_reports() va main() da. if __name__ == "__main__": qatori (Modullar va import darsidan) dasturni işga tuşirmasdan bu funksiyalarni test faylida import qiliş imkonini beradi.
Sof funksiyalarni testlaş
Funksiyalarning köpçiligi sof bölgani uçun ularni testlaş oson. Haqiqiy loyihada bularni test_text_analyzer.py ga joylang, boşiga from text_analyzer import ... ni yozing va pytest ni işga tuşiring. Bu yerda blok mustaqil işlaşi uçun funksiyalar takrorlangan va testlar qölda çaqirilgan:
import re
from collections import Counter

WORD_RE = re.compile(r"[a-zöğşç]+(?:ʼ[a-zöğşç]+)*")
SENTENCE_END_RE = re.compile(r"[.!?]+(?:\s|$)")
EMAIL_RE = re.compile(r"[\w.+-]+@[\w-]+(?:\.[\w-]+)*\.[a-z]{2,}", re.IGNORECASE)

def iter_words(text):
    for match in WORD_RE.finditer(text.lower()):
        yield match.group()

def count_sentences(text):
    return len(SENTENCE_END_RE.findall(text.strip()))

def top_words(words, n=5, stop_words=frozenset()):
    counts = Counter(w for w in words if w not in stop_words)
    return counts.most_common(n)

def longest_words(words, n=3):
    return sorted(set(words), key=lambda w: (-len(w), w))[:n]

def reading_time(word_count, wpm=200):
    return round(word_count / wpm, 1)


def test_iter_words_ignores_case_and_punctuation():
    assert list(iter_words("Çoy, ÇOY! çoy?")) == ["çoy", "çoy", "çoy"]

def test_iter_words_keeps_apostrophes():
    assert list(iter_words("Maʼlumot va TAʼLIM")) == ["maʼlumot", "va", "taʼlim"]

def test_iter_words_empty_text():
    assert list(iter_words("")) == []
    assert list(iter_words("123 !!! 45")) == []

def test_count_sentences():
    assert count_sentences("Bir. Ikki! Uç?") == 3
    assert count_sentences("Kutib turing?! Rostdanmi...") == 2
    assert count_sentences("Pi 3.14 ga teng, sayt esa cafe.uz") == 0
    assert count_sentences("") == 0

def test_top_words_uses_stop_words():
    words = ["va", "çoy", "va", "çoy", "palov"]
    assert top_words(words, n=1, stop_words={"va"}) == [("çoy", 2)]

def test_longest_words_ties_are_alphabetical():
    assert longest_words(["çoy", "palov", "non", "somsa", "lağmon"], n=2) == ["lağmon", "palov"]

def test_reading_time():
    assert reading_time(0) == 0.0
    assert reading_time(1000) == 5.0
    assert reading_time(300, wpm=250) == 1.2

def test_email_pattern():
    text = "aziza@cafe.uz yoki JOBS@Cafe.UZ ga yozing, @cafe yoki aziza@ ga emas"
    assert EMAIL_RE.findall(text) == ["aziza@cafe.uz", "JOBS@Cafe.UZ"]


tests = [
    test_iter_words_ignores_case_and_punctuation,
    test_iter_words_keeps_apostrophes,
    test_iter_words_empty_text,
    test_count_sentences,
    test_top_words_uses_stop_words,
    test_longest_words_ties_are_alphabetical,
    test_reading_time,
    test_email_pattern,
]
for test in tests:
    test()
print("ötdi:", test.__name__)ötdi: test_iter_words_ignores_case_and_punctuation
ötdi: test_iter_words_keeps_apostrophes
ötdi: test_iter_words_empty_text
ötdi: test_count_sentences
ötdi: test_top_words_uses_stop_words
ötdi: test_longest_words_ties_are_alphabetical
ötdi: test_reading_time
ötdi: test_email_patternTestlar nimalarni qamrab olganiga qarang: oddiy kiritiş, çegaraviy holatlar (böş matn, faqat sonlar) va quriş jarayonida topilgan nozik holatlar (tutuq belgisi, katta özbekça harflar, 3.14, teng uzunliklar). Test holatlarini tanlaş darsida örganganingizdek, tuzatilgan har bir xato yangi test qöşiş uçun yaxşi sabab.
Özingiz sinab köring
Tahlilçining ixçam versiyasi şu yerning özida işlaydi. Öz matningizni joylaştiring yoki yordamçi sözlarni özgartiring.
Köp uçraydigan xatolar
1. Faylni kodlaşni körsatmasdan öqiş
encoding= körsatilmasa, Python kompyuterning standart kodlaşini işlatadi. U Windows da Linux yoki macOS dagidan farq qilişi mumkin, şuning uçun bitta dastur faylni bir kompyuterda öqib, boşqasida xato berişi mumkin. Bundan taşqari, matn fayllari har doim ham UTF-8 da saqlanmaydi. Eski Windows kodlaşida saqlangan fayl esa UTF-8 ni körsatsangiz ham xato beradi:
from pathlib import Path

Path("old.txt").write_bytes("Ташкент, Самарканд".encode("cp1251"))
text = Path("old.txt").read_text(encoding="utf-8")UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd2 in position 0: invalid continuation byteTuzatiş: dasturingiz har bir kompyuterda bir xil işlaşi uçun doim encoding="utf-8" ni uzating va tuşunarli xabar körsatiş (yoki boşqa kodlaşni sinab köriş) uçun UnicodeDecodeError ni uşlang.
2. Kiçik harflarga özgartirişni unutiş
from collections import Counter

words = "Çoy juda yaxşi. ÇOY juda arzon. çoy juda issiq.".replace(".", "").split()
print(Counter(words).most_common(2))
print(Counter(w.lower() for w in words).most_common(2))[('juda', 3), ('Çoy', 1)]
[('çoy', 3), ('juda', 3)]Tuzatiş: harf registrini sözlarni hosil qiladigan funksiyada bir marta normallaştiring, şunda qolgan barça funksiyalar toza maʼlumot oladi.
3. Tiniş belgilarini ajratmaslik
from collections import Counter

text = "Palov, palov va yana palov!"
print(Counter(text.lower().split()))Counter({'palov,': 1, 'palov': 1, 'va': 1, 'yana': 1, 'palov!': 1})"palov,", "palov" va "palov!" alohida sanaladi. Tuzatiş: sözlarni split() örniga [a-zöğşç]+ kabi regex bilan ajratib oling.
4. Böş faylda qulaş
text = ""
words = text.split()
average_length = sum(len(w) for w in words) / len(words)ZeroDivisionError: division by zeroTuzatiş: main() ning boşidayoq if not text.strip(): ni tekşiring va har bir bölişni himoyalang: total / count if count else 0.0. Ataylab böş satr bilan testlang.
Qöşimça topşiriqlar
Bular loyihani kengaytiradi. Maslahatlarni oçişdan oldin har birini özingiz sinab köring.
1. Fayl nomini söraş
Faylni foydalanuvçi tanlasin: input("Tahlil qilinadigan fayl: ") dan foydalaning va fayl mavjud bölmasa, traceback örniga tuşunarli xabar çiqaring.
Maslahatlar
Path(name).exists()fayl bor-yöqligini aytadi. Yokiread_textnitry/except FileNotFoundErrorga öring.- Tekşiruvni sof funksiyalarda emas,
main()da saqlang.
2. Xatboşidagi sözlar soni
TextStats ga words_per_paragraph maydonini (butun sonlar röyxati) qöşing va uni matnli hisobotda Xatboşidagi sözlar: 31, 34, 28 kabi körsating.
Maslahatlar
count_paragraphsdagire.split(r"\n\s*\n", text)dan qayta foydalaning, keyin har bir qismdagi sözlarniiter_wordsbilan sanang.sum(1 for _ in iter_words(paragraph))röyxat qurmasdan sanaydi.- Bitta xatboşili matn va böş qatorli matn uçun test qöşişni unutmang.
3. Yordamçi sözlarni fayldan yuklaş
Yordamçi sözlarni kodga yozib qöyilgan töplam örniga stop_words.txt dan yuklang (har qatorda bitta söz, # bilan boşlanadigan qatorlar izoh).
Maslahatlar
- Iteratorlar va generatorlar darsidagidek generator konveyerini yozing: qatorlarni öqiş, tozalaş, böş qatorlar va izohlarni ötkazib yuboriş.
- Töplamni
{line.lower() for line in ...}bilan quring. - Töplamni
top_words(words, stop_words=...)ga uzating. Aynan şuning uçun u parametr qilingan edi.
4. Ikki matnni taqqoslaş
Ikki faylni tahlil qiling va yonma-yon taqqoslaşni çiqaring: sözlar, gaplar, gapning örtaça uzunligi va ikkala matnning top 10 taligida uçraydigan sözlar.
Maslahatlar
analyze()ni ikki marta çaqiring. IkkitaTextStatsobyektini olasiz.- Har bir
top_wordsröyxatidan sözlar töplamini quring va kesişma uçun&dan foydalaning. - Ustunlarni
f"{label:<20}{a:>8}{b:>8}"kabi f-satrlar bilan formatlang.
5. Ulkan fayllar uçun oqimli tahlilçi
Sözlarni sanaşni bir neçta gigabaytlik faylda işlaydigan qilib qayta yozing: heç qaçon read_text() ni yoki barça sözlarga list() ni çaqirmang. Qatorma-qator öqiş davomida sözlar sonini, eng köp uçraydigan sözlarni va eng uzun sözni sanang.
Maslahatlar
- Faylni
open(path, encoding="utf-8")bilan oçing va qatorlar böyiça sikl yurgizing. Har bir qatorremove_linksvaiter_wordsdan ötadi. Counter.update(iterable)generatordan sanoqlarni qöşadi.- Röyxat örniga joriy sözlar soni va hozirgi eng uzun sözni özgaruvçilarda saqlang.
- Gaplar bir neçta qatorga çözilişi mumkin, şuning uçun oqimli rejimda ularni aniq sanaş qiyinroq. Taxminiy natija (har qator böyiça sanaş) maqbulmi-yöqmi, hal qiling va bu qarorni izohda yozing.
Xulosa
- Loyihani kod yozişdan oldin kiçik funksiyalar va maʼlumotlar oqimi röyxati sifatida rejalaştiring.
- Matnni erta normallaştiring: kiçik harflarga özgartiring, sözlarni özbekça harflarni ham hisobga oladigan regex bilan ajratib oling, sanaşdan oldin emaillar va URL larni olib taşlang.
Counter.most_common()va yordamçi sözlar töplami maʼnoli köp uçraydigan sözlarni topadi, ikki qismli saralaş kaliti esa natijalarni barqaror qiladi.- Çegaraviy holatlar dasturni qulatmasligi uçun har bir bölişni himoyalang va böş kiritişni tekşiring.
- Dataclass köp natijalarni aniq nomlar ostida yiğadi,
asdict()esa uni JSON ga aylantiradi. - Hisob-kitoblarni sof, fayl va ekran bilan işlaşni esa çetlarda saqlang. Sof funksiyalarni oddiy
assertyokipytestbilan testlaş oson.