

pandas asoslari
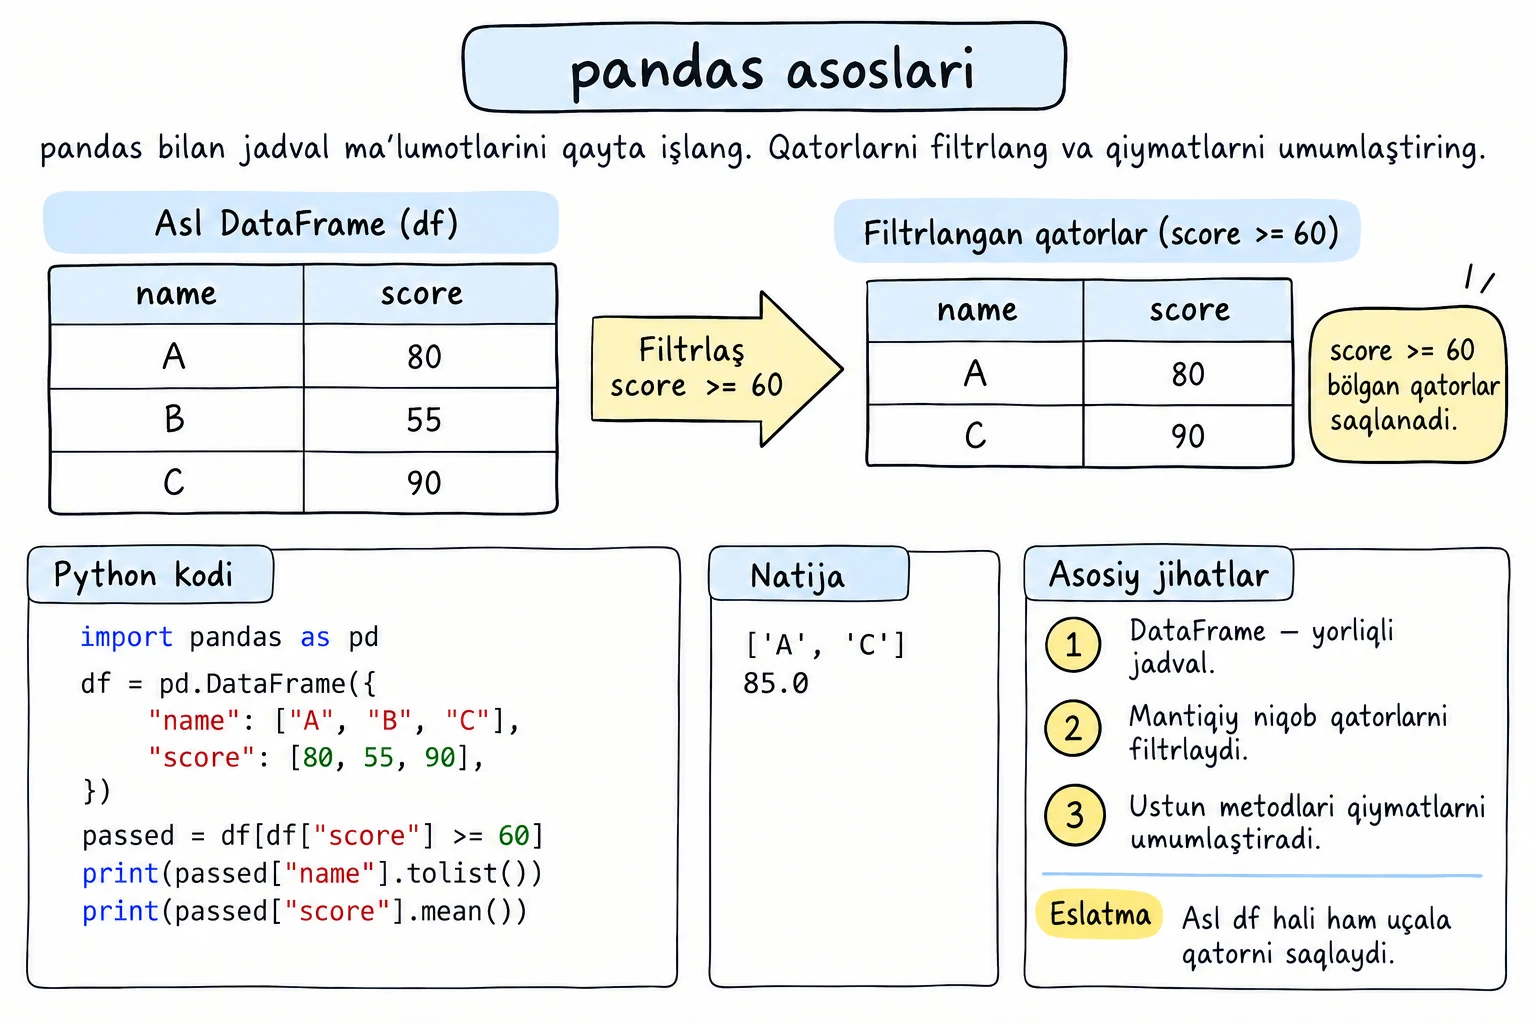
Nimalarni örganasiz
- Hisoblangan ustunlarni qöşiş va qatorlarni saralaşni
groupby,aggvapivot_tablebilan qiymatlarni sanaş va guruhlarni umumlaştirişni- Jadvalni tozalaş (
drop_duplicates,rename,drop) hamdaconcatvamergebilan jadvallarni birlaştirişni - Butun ustunlardagi matn (
.str) va sanalar (.dt) bilan işlaşni applyqaçon kerakligini, nega vektorlaşgan amallar odatda yaxşiroq ekanini va zanjirli indekslaşdan qanday saqlanişni
Nega bu muhim
Maʼlumot fayllarini öqiş darsida siz jadvallarni yuklagansiz va qatorlarni tanlagansiz. pandasʼning haqiqiy qiymati keyingi bosqiçda - savollarga javob berişda namoyon böladi. "Qaysi şahar eng köp daromad qildi?", "Har oyda har bir mahsulot uçun örtaça buyurtma qança?", "Samarqandlik qaysi mijozlar şarbat sotib olgan?" Oddiy Pythonda bularning har biri sikl va jami summalar luğatini talab qiladi. pandasʼda esa har biri bir-ikki qator, va xuddi şu kod 10 qator uçun ham, 10 million qator uçun ham işlaydi.
Savdo maʼlumotlari
Bu darsdagi köp misollar dökon savdolarining bir xil kiçik jadvalidan foydalanadi. U io.StringIO yordamida matndan yaratiladi, şuning uçun har bir misol mustaqil işlaydi:
import io
import pandas as pd

text = """date,city,product,quantity,price
2026-01-05,Toşkent,Çoy,4,15000
2026-01-12,Samarqand,Somsa,10,8000
2026-01-20,Toşkent,Şarbat,3,12000
2026-02-03,Buxoro,Çoy,5,15000
2026-02-14,Toşkent,Somsa,12,8000
2026-02-21,Samarqand,Şarbat,6,12000
2026-03-02,Buxoro,Somsa,8,8000
2026-03-10,Toşkent,Çoy,7,15000
2026-03-18,Samarqand,Çoy,2,15000
2026-03-25,Buxoro,Şarbat,4,12000
"""
sales = pd.read_csv(io.StringIO(text), parse_dates=["date"])
print(sales) date city product quantity price
0 2026-01-05 Toşkent Çoy 4 15000
1 2026-01-12 Samarqand Somsa 10 8000
2 2026-01-20 Toşkent Şarbat 3 12000
3 2026-02-03 Buxoro Çoy 5 15000
4 2026-02-14 Toşkent Somsa 12 8000
5 2026-02-21 Samarqand Şarbat 6 12000
6 2026-03-02 Buxoro Somsa 8 8000
7 2026-03-10 Toşkent Çoy 7 15000
8 2026-03-18 Samarqand Çoy 2 15000
9 2026-03-25 Buxoro Şarbat 4 12000parse_dates=["date"] sana ustunini öqiş paytidayoq aylantiradi, bu alohida pd.to_datetime() çaqirişini tejaydi.
Hisoblangan ustunlar
Yangi ustun nomiga qiymat berilsa, şu ustun yaratiladi. Hisob barça qatorlar uçun bir yöla, siklsiz bajariladi:
import io
import pandas as pd

text = """date,city,product,quantity,price
2026-01-05,Toşkent,Çoy,4,15000
2026-01-12,Samarqand,Somsa,10,8000
2026-02-03,Buxoro,Çoy,5,15000
"""
sales = pd.read_csv(io.StringIO(text))

sales["revenue"] = sales["quantity"] * sales["price"]
sales["big_order"] = sales["revenue"] >= 75000
print(sales)
print()
print("Jami:", sales["revenue"].sum()) date city product quantity price revenue big_order
0 2026-01-05 Toşkent Çoy 4 15000 60000 False
1 2026-01-12 Samarqand Somsa 10 8000 80000 True
2 2026-02-03 Buxoro Çoy 5 15000 75000 True
Jami: 215000Bitta amal butun ustun ustida işlaydigan bu uslub vektorlaşgan (vectorized) amal deyiladi. U sikldan qisqaroq va ança tezroq, çunki pandas siklni optimallaştirilgan kompilyatsiya qilingan kodda bajaradi.
Saralaş
sort_values() bir yoki bir neça ustun böyiça saralaydi. ascending=False eng kattasini birinçi qöyadi:
import io
import pandas as pd

text = """city,product,quantity,price
Toşkent,Çoy,4,15000
Samarqand,Somsa,10,8000
Toşkent,Şarbat,3,12000
Buxoro,Çoy,5,15000
Toşkent,Somsa,12,8000
"""
sales = pd.read_csv(io.StringIO(text))
sales["revenue"] = sales["quantity"] * sales["price"]

print(sales.sort_values("revenue", ascending=False))
print()
print(sales.sort_values(["city", "revenue"], ascending=[True, False])) city product quantity price revenue
4 Toşkent Somsa 12 8000 96000
1 Samarqand Somsa 10 8000 80000
3 Buxoro Çoy 5 15000 75000
0 Toşkent Çoy 4 15000 60000
2 Toşkent Şarbat 3 12000 36000
city product quantity price revenue
3 Buxoro Çoy 5 15000 75000
1 Samarqand Somsa 10 8000 80000
4 Toşkent Somsa 12 8000 96000
0 Toşkent Çoy 4 15000 60000
2 Toşkent Şarbat 3 12000 36000Ikkinçi saralaş şaharlarni alifbo tartibida, keyin har bir şahar içida daromadni kattadan kiçikka qarab joylaştiradi. Indeks yorliqlari öz qatorlari bilan birga köçişiga eʼtibor bering. Yangi 0, 1, 2, ... indeks kerak bölsa, .reset_index(drop=True) qöşing. Faqat eng yuqori qatorlar uçun sales.nlargest(3, "revenue") qulay qisqa yöl.
value_counts bilan sanaş
value_counts() har bir qiymat neça marta uçrayotganini sanaydi, xuddi collections.Counter kabi:
import io
import pandas as pd

text = """city,product
Toşkent,Çoy
Samarqand,Somsa
Toşkent,Şarbat
Buxoro,Çoy
Toşkent,Somsa
Samarqand,Şarbat
"""
sales = pd.read_csv(io.StringIO(text))

print(sales["city"].value_counts())
print()
print(sales["city"].value_counts(normalize=True).round(2))city
Toşkent 3
Samarqand 2
Buxoro 1
Name: count, dtype: int64
city
Toşkent 0.50
Samarqand 0.33
Buxoro 0.17
Name: proportion, dtype: float64normalize=True sonlar örniga uluşlarni beradi: buyurtmalarning yarmi Toşkentdan kelgan.
groupby bilan guruhlaş
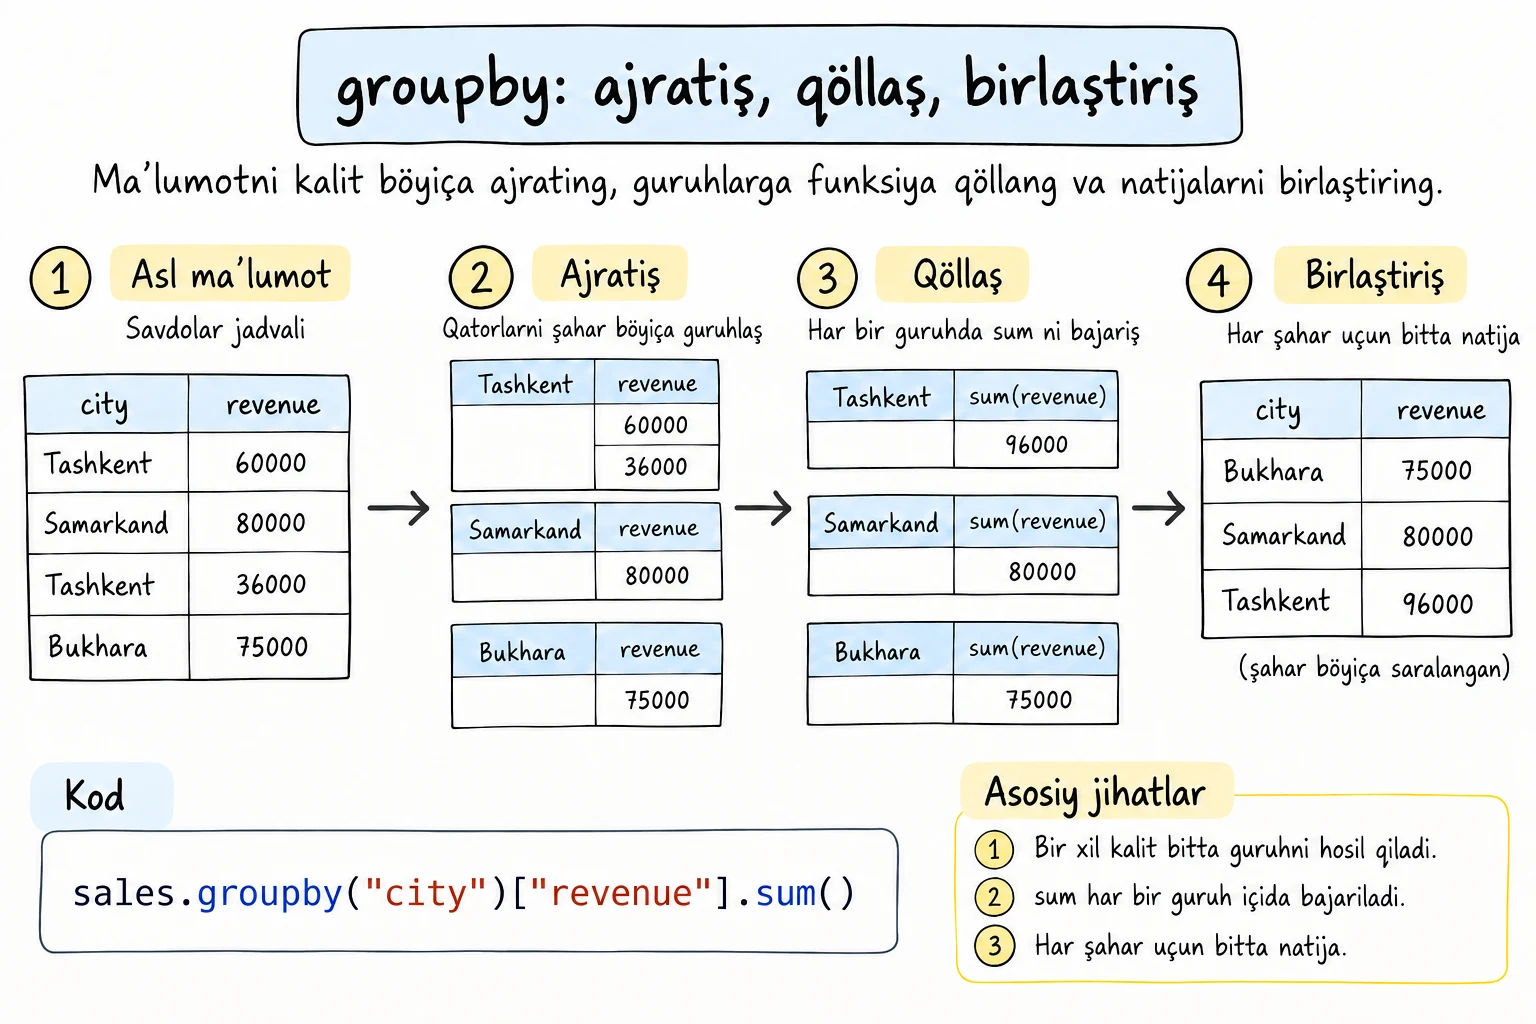
groupby "har bir X uçun Y qança?" degan savolga javob beradi. U uç qadamda işlaydi: qatorlarni guruhlarga ajratiş (split), har bir guruhga hisobni qöllaş (apply) va natijalarni birlaştiriş (combine).
asl qatorlar        guruhlarga ajratiş     qöllaş: sum    birlaştiriş
Toşkent    60000    Buxoro     75000   ->  75000          Buxoro     75000
Samarqand  80000    Samarqand  80000   ->  80000          Samarqand  80000
Toşkent    36000    Toşkent    60000                      Toşkent    96000
Buxoro 75000 Toşkent 36000 -> 96000import io
import pandas as pd
text = """date,city,product,quantity,price
2026-01-05,Toşkent,Çoy,4,15000
2026-01-12,Samarqand,Somsa,10,8000
2026-01-20,Toşkent,Şarbat,3,12000
2026-02-03,Buxoro,Çoy,5,15000
2026-02-14,Toşkent,Somsa,12,8000
2026-02-21,Samarqand,Şarbat,6,12000
2026-03-02,Buxoro,Somsa,8,8000
2026-03-10,Toşkent,Çoy,7,15000
2026-03-18,Samarqand,Çoy,2,15000
2026-03-25,Buxoro,Şarbat,4,12000
"""
sales = pd.read_csv(io.StringIO(text), parse_dates=["date"])
sales["revenue"] = sales["quantity"] * sales["price"]
print(sales.groupby("city")["revenue"].sum())
print()
print(sales.groupby("product")["quantity"].mean())
print()
print(sales.groupby("city").size())city
Buxoro 187000
Samarqand 182000
Toşkent 297000
Name: revenue, dtype: int64
product
Somsa 10.000000
Çoy 4.500000
Şarbat 4.333333
Name: quantity, dtype: float64
city
Buxoro 3
Samarqand 3
Toşkent 4
dtype: int64Andoza doim bir xil: df.groupby(key)[column].calculation(). Natija - indeksi guruh nomlaridan iborat, saralangan Series (matnlar belgilar kodi böyiça saralanadi, şuning uçun Çoy va Şarbat Somsa dan keyin keladi). .size() har bir guruhdagi qatorlarni sanaydi. .count() ham bor, lekin u har bir ustundagi yöq bölmagan qiymatlarni sanaydi.
agg bilan bir neça hisob bir yöla
agg() bir neça agregatsiyani bir martada bajaradi. Nomlangan agregatsiyalar natija ustunlarining nomini tanlaş imkonini beradi:
import io
import pandas as pd

text = """city,product,quantity,price
Toşkent,Çoy,4,15000
Samarqand,Somsa,10,8000
Toşkent,Şarbat,3,12000
Buxoro,Çoy,5,15000
Toşkent,Somsa,12,8000
Samarqand,Şarbat,6,12000
Buxoro,Somsa,8,8000
Toşkent,Çoy,7,15000
Samarqand,Çoy,2,15000
Buxoro,Şarbat,4,12000
"""
sales = pd.read_csv(io.StringIO(text))
sales["revenue"] = sales["quantity"] * sales["price"]

summary = sales.groupby("city").agg(
    orders=("revenue", "count"),
    total=("revenue", "sum"),
    average=("revenue", "mean"),
    biggest=("quantity", "max"),
)
print(summary.sort_values("total", ascending=False).round(1)) orders total average biggest
city
Toşkent 4 297000 74250.0 12
Buxoro 3 187000 62333.3 8
Samarqand 3 182000 60666.7 10Har bir argument new_name=(column, calculation) deb öqiladi. groupby(["city", "product"]) kabi ikki ustun böyiça guruhlaş har bir kombinatsiya uçun bitta qator beradi.
Guruh jamilarini har bir qatorga qaytariş
Haqiqiy hisobotlarda groupby yonida köpinça yana ikkita vosita uçraydi. idxmax() eng katta qiymatning yorliğini qaytaradi (qança emas, qaysi şahar), transform("sum") esa har bir guruh jamisini şu guruhning har bir qatoriga qaytaradi, şunda uluşlarni hisoblaş mumkin:
import io
import pandas as pd

text = """city,quantity,price
Toşkent,4,15000
Samarqand,10,8000
Toşkent,3,12000
Buxoro,5,15000
"""
sales = pd.read_csv(io.StringIO(text))
sales["revenue"] = sales["quantity"] * sales["price"]

by_city = sales.groupby("city")["revenue"].sum()
print(by_city.idxmax(), by_city.max())

sales["city_share"] = sales["revenue"] / sales.groupby("city")["revenue"].transform("sum")
print(sales[["city", "revenue", "city_share"]].round(2))Toşkent 96000
city revenue city_share
0 Toşkent 60000 0.62
1 Samarqand 80000 1.00
2 Toşkent 36000 0.38
3 Buxoro 75000 1.00Yiğma jadvallar
Yiğma jadval (pivot table) bir guruhlaşni qatorlar böylab, boşqasini ustunlar böylab joylaştiradi - xuddi elektron jadvaldagi hisobot kabi:
import io
import pandas as pd

text = """city,product,quantity,price
Toşkent,Çoy,4,15000
Samarqand,Somsa,10,8000
Toşkent,Şarbat,3,12000
Buxoro,Çoy,5,15000
Toşkent,Somsa,12,8000
Samarqand,Şarbat,6,12000
Buxoro,Somsa,8,8000
Toşkent,Çoy,7,15000
Samarqand,Çoy,2,15000
Buxoro,Şarbat,4,12000
"""
sales = pd.read_csv(io.StringIO(text))
sales["revenue"] = sales["quantity"] * sales["price"]

table = sales.pivot_table(
    index="city",
    columns="product",
    values="revenue",
    aggfunc="sum",
    fill_value=0,
    margins=True,
)
print(table)product Somsa Çoy Şarbat All
city
Buxoro 64000 75000 48000 187000
Samarqand 80000 30000 72000 182000
Toşkent 96000 165000 36000 297000
All 240000 270000 156000 666000fill_value=0 savdo bölmagan kombinatsiyalarni töldiradi, margins=True esa jami qiymatlar bilan All qatori va ustunini qöşadi.
Tozalaş yordamçilari
Yangi yuklangan jadvalni uçta metod tartibga soladi. drop_duplicates() aynan takrorlanadigan (yoki subset= bilan körsatilgan ustunlarda takrorlanadigan) qatorlarni olib taşlaydi, rename() ustun nomlarini tuzatadi, drop() esa keraksiz ustunlarni olib taşlaydi:
import pandas as pd

orders = pd.DataFrame({
    "Order ID": [101, 102, 102, 103],
    "customer": ["Aziza", "Bekzod", "Bekzod", "Dilnoza"],
    "product": ["Çoy", "Somsa", "Somsa", "Çoy"],
    "note": ["", "", "", "sovğa"],
})

clean = (
    orders.drop_duplicates()                    # aynan takrorlangan qatorlarni olib taşlaş
    .rename(columns={"Order ID": "order_id"})   # ustun nomlarini tartibga keltiriş
    .drop(columns=["note"])                     # keraksiz ustunlarni olib taşlaş
)
print(clean) order_id customer product
0 101 Aziza Çoy
1 102 Bekzod Somsa
3 103 Dilnoza ÇoyIndeks eski yorliqlarini (0, 1, 3) saqlab qoladi; yana 0, 1, 2 kerak bölsa, .reset_index(drop=True) qöşing.
Jadvallarni birlaştiriş
Ikki jadvalda bir xil ustunlar bölsa, masalan har oy uçun alohida fayl, pd.concat() ularni ustma-ust qöyadi:
import pandas as pd

january = pd.DataFrame({"city": ["Toşkent", "Buxoro"], "revenue": [176000, 90000]})
february = pd.DataFrame({"city": ["Toşkent", "Samarqand"], "revenue": [130000, 113000]})

print(pd.concat([january, february], ignore_index=True)) city revenue
0 Toşkent 176000
1 Buxoro 90000
2 Toşkent 130000
3 Samarqand 113000Ikki jadvalda buning örniga umumiy kalit ustun bölsa, ularni merge() birlaştiradi.
Ikki jadvalni kalit böyiça birlaştiriş
Bu yerda har bir buyurtmada faqat mahsulot nomi bor, mahsulot tafsilotlari esa ikkinçi jadvalda. merge() har bir mahsulotni xuddi butun ustun uçun luğatdan qidirgandek topadi:
import pandas as pd

orders = pd.DataFrame({
    "order_id": [101, 102, 103, 104],
    "customer": ["Aziza", "Bekzod", "Dilnoza", "Farrux"],
    "product": ["Çoy", "Somsa", "Çoy", "Holva"],
    "quantity": [2, 5, 1, 3],
})
products = pd.DataFrame({
    "product": ["Çoy", "Somsa", "Şarbat"],
    "price": [15000, 8000, 12000],
    "category": ["içimlik", "taom", "içimlik"],
})

merged = orders.merge(products, on="product", how="left")
print(merged)
print()
print(orders.merge(products, on="product")) order_id customer product quantity price category
0 101 Aziza Çoy 2 15000.0 içimlik
1 102 Bekzod Somsa 5 8000.0 taom
2 103 Dilnoza Çoy 1 15000.0 içimlik
3 104 Farrux Holva 3 NaN NaN
order_id customer product quantity price category
0 101 Aziza Çoy 2 15000 içimlik
1 102 Bekzod Somsa 5 8000 taom
2 103 Dilnoza Çoy 1 15000 içimlikhow argumenti mos kelmagan qatorlar bilan nima bölişini belgilaydi:
how | Nimani qoldiradi |
|---|---|
"inner" (standart) | faqat ikkala jadvalda ham bor kalitlarni |
"left" | çap jadvalning har bir qatorini, mos kelmagan joyda NaN bilan |
"right" | öng jadvalning har bir qatorini |
"outer" | ikkala jadvalning barça qatorlarini |
Holva mahsulotlar röyxatida yöq, şuning uçun left merge Farruxning buyurtmasini NaN narx bilan qoldiradi, inner merge esa uni olib taşlaydi. Left mergeʼdan keyin isna() işlatiş - bunday topilmagan qiymatlarni aniqlaşning tez usuli.
Matnli ustunlar: .str accessor
Satr metodlari va kesimlar darsidagi satr metodlari .str orqali butun ustunda işlaydi:
import pandas as pd

customers = pd.DataFrame({
    "name": ["  aziza KARIMOVA", "Bekzod Tursunov ", "dilnoza rahimova"],
    "email": ["aziza@mail.uz", "bekzod@gmail.com", "dilnoza@mail.uz"],
})

customers["name"] = customers["name"].str.strip().str.title()
customers["domain"] = customers["email"].str.split("@").str[1]
print(customers)
print()
print(customers[customers["email"].str.contains("mail.uz", regex=False)])
print(customers["name"].str.lower().str.startswith("b").tolist()) name email domain
0 Aziza Karimova aziza@mail.uz mail.uz
1 Bekzod Tursunov bekzod@gmail.com gmail.com
2 Dilnoza Rahimova dilnoza@mail.uz mail.uz
name email domain
0 Aziza Karimova aziza@mail.uz mail.uz
2 Dilnoza Rahimova dilnoza@mail.uz mail.uz
[False, True, False].str.contains() standart holatda andozani regulyar ifoda (regex) sifatida qabul qiladi, şuning uçun Regulyar ifodalar darsidagi re sintaksisi u yerda işlaydi. Bu yerda regex=False nuqtani oddiy nuqta qiladi. Metodlar tabiiy ravişda zanjir hosil qiladi: .str.strip().str.title().
Sana ustunlari: .dt accessor
Sana-vaqt ustunlarida har bir sananing qismlarini oliş uçun .dt accessor bor. groupby bilan birga u oylik hisobotlarni beradi:
import io
import pandas as pd

text = """date,city,product,quantity,price
2026-01-05,Toşkent,Çoy,4,15000
2026-01-12,Samarqand,Somsa,10,8000
2026-01-20,Toşkent,Şarbat,3,12000
2026-02-03,Buxoro,Çoy,5,15000
2026-02-14,Toşkent,Somsa,12,8000
2026-02-21,Samarqand,Şarbat,6,12000
2026-03-02,Buxoro,Somsa,8,8000
2026-03-10,Toşkent,Çoy,7,15000
2026-03-18,Samarqand,Çoy,2,15000
2026-03-25,Buxoro,Şarbat,4,12000
"""
sales = pd.read_csv(io.StringIO(text), parse_dates=["date"])
sales["revenue"] = sales["quantity"] * sales["price"]

sales["month"] = sales["date"].dt.month
sales["weekday"] = sales["date"].dt.day_name()
print(sales[["date", "month", "weekday"]].head(3))
print()
print(sales.groupby("month")["revenue"].sum())
print()
monthly = sales.set_index("date").resample("MS")["revenue"].sum()
print(monthly) date month weekday
0 2026-01-05 1 Monday
1 2026-01-12 1 Monday
2 2026-01-20 1 Tuesday
month
1 176000
2 243000
3 247000
Name: revenue, dtype: int64
date
2026-01-01 176000
2026-02-01 243000
2026-03-01 247000
Freq: MS, Name: revenue, dtype: int64resample("MS") sana indeksini kalendar oylariga guruhlaydi va ularni oy boşi (month start) bilan belgilaydi. Oy raqami böyiça guruhlaşdan farqli ravişda, u yilni saqlaydi va böş oylarni 0 jami bilan qöşadi. Oylarni matn bilan belgilaş uçun sales["date"].dt.strftime("%Y-%m") böyiça guruhlang (Sana va vaqt darsidagi format kodlari), keyin monthly.pct_change() har bir oydan keyingisigaça özgarişni uluş sifatida beradi (0.381 +38.1% degani; birinçi oy NaN, çunki undan oldingi oy yöq). day_name() hafta kunlarini inglizça qaytaradi.
apply: öz funksiyangizni işga tuşiriş
Heç qaysi tayyor amal mos kelmasa, apply() funksiyangizni har bir qiymat uçun bir martadan çaqiradi:
import pandas as pd

scores = pd.DataFrame({
    "student": ["Aziza", "Bekzod", "Dilnoza", "Farrux"],
    "score": [93, 71, 85, 58],
})

def letter(score):
    if score >= 90:
        return "A"
    if score >= 80:
        return "B"
    if score >= 60:
        return "C"
    return "F"

scores["grade"] = scores["score"].apply(letter)
print(scores) student score grade
0 Aziza 93 A
1 Bekzod 71 C
2 Dilnoza 85 B
3 Farrux 58 Fapply moslanuvçan, lekin aslida bu yaşiringan Python sikli. Agar vektorlaşgan varianti bölsa, uni afzal köring: prices["price"] * 1.12 prices["price"].apply(lambda p: p * 1.12) dan soddaroq va katta maʼlumotlarda köpinça 10-100 barobar tezroq.
Oraliqlarga asoslangan toifalar uçun pd.cut() letter funksiyasining vektorlaşgan muqobili: pd.cut(scores["score"], bins=[0, 59, 79, 89, 100], labels=["F", "C", "B", "A"], include_lowest=True). Har bir oraliq öng çegarasini öz içiga oladi, şuning uçun butun sonli ballar uçun (59, 79] 60 dan 79 gaça degani; include_lowest=True esa roppa-rosa 0 ballni ham NaN örniga birinçi oraliqqa joylaydi.
Metodlar zanjiri
Metodlarning köpçiligi yangi DataFrame qaytargani uçun, ularni öqiş oson bölgan zanjirga ulaş mumkin. Zanjirni qavsga oling va har bir qadamni alohida qatorga yozing:
import io
import pandas as pd

text = """date,city,product,quantity,price
2026-01-05,Toşkent,Çoy,4,15000
2026-01-12,Samarqand,Somsa,10,8000
2026-01-20,Toşkent,Şarbat,3,12000
2026-02-03,Buxoro,Çoy,5,15000
2026-02-14,Toşkent,Somsa,12,8000
2026-02-21,Samarqand,Şarbat,6,12000
2026-03-02,Buxoro,Somsa,8,8000
2026-03-10,Toşkent,Çoy,7,15000
2026-03-18,Samarqand,Çoy,2,15000
2026-03-25,Buxoro,Şarbat,4,12000
"""

report = (
    pd.read_csv(io.StringIO(text), parse_dates=["date"])
    .assign(revenue=lambda d: d["quantity"] * d["price"])
    .query("product != 'Somsa'")
    .groupby("city", as_index=False)["revenue"]
    .sum()
    .sort_values("revenue", ascending=False)
)
print(report) city revenue
2 Toşkent 201000
0 Buxoro 123000
1 Samarqand 102000assign() ustun qöşadi va yangi DataFrame qaytaradi. lambda d: zanjirning şu nuqtasidagi DataFrameʼni qabul qiladi. query() qisqa ifoda satri bilan filtrlaydi, as_index=False esa city ni oddiy ustun sifatida saqlaydi. Zanjirni retsept kabi yuqoridan pastga öqing.
Özingiz sinab köring
Guruhlaş ustunini özgartiring, yana bir agregatsiya qöşing yoki boşqa mahsulotni filtrlang.
Köp uçraydigan xatolar
1. Şartlarni birlaştiriş uçun and/or işlatiş
import pandas as pd

sales = pd.DataFrame({"city": ["Toşkent", "Buxoro"], "quantity": [4, 12]})
print(sales[sales["city"] == "Toşkent" and sales["quantity"] > 5])ValueError: The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all().and Pythondan butun Series rostmi yoki yöqmi deb söraydi, bunga esa bitta javob yöq. Har bir şartni qavsga olib, &, |, ~ dan foydalaning: sales[(sales["city"] == "Toşkent") & (sales["quantity"] > 5)].
2. Qiymat berişda zanjirli indekslaş
Ketma-ket ikki juft qavs - avval filtrlaş, keyin ustun tanlaş - vaqtinçalik nusxa yaratadi. Bu nusxaga berilgan qiymat aslga heç qaçon yetib bormaydi:
import pandas as pd

sales = pd.DataFrame({"city": ["Toşkent", "Buxoro"], "price": [15000, 8000]})
sales[sales["city"] == "Buxoro"]["price"] = 9000    # Yomon: zanjirli indekslaş
print(sales)                                        # Buxoro hali ham 8000
pandas 3 quyidagiça boşlanadigan ogohlantiriş çiqaradi (pandas 2 esa uning örniga SettingWithCopyWarning körsatadi):
ChainedAssignmentError: A value is being set on a copy of a DataFrame or Series through chained assignment.Tanlaş va qiymat berişni bitta .loc qadamida bajaring:
import pandas as pd

sales = pd.DataFrame({"city": ["Toşkent", "Buxoro"], "price": [15000, 8000]})
sales.loc[sales["city"] == "Buxoro", "price"] = 9000    # Yaxşi
print(sales) city price
0 Toşkent 15000
1 Buxoro 90003. Filtrlangan qismni .copy() siz özgartiriş
tashkent = sales[sales["city"] == "Toşkent"]
tashkent["price"] = tashkent["price"] * 2     # Yomon: pandas 2 da SettingWithCopyWarning
pandas 3 da bu qator ogohlantirişsiz işlaydi: Copy-on-Write tufayli tashkent ni özgartiriş heç qaçon sales ni özgartirmaydi. pandas 2 da esa u ogohlantiriş çiqaradi va kodni öqiyotganlar nima özgarganini aniq bilmay qoladi. Agar özgartiriladigan mustaqil qism kerak bölsa, buni oçiq ayting: tashkent = sales[sales["city"] == "Toşkent"].copy(). Bu pandasʼning har qanday versiyasida jimgina işlaydi va sales özgarmay qolişi aniq körinadi.
4. Ustunlardan foydalaniş örniga qatorlar böylab sikl yoziş
# Yomon: sekin va uzun
totals = []
for i, row in sales.iterrows():
    totals.append(row["quantity"] * row["price"])
sales["revenue"] = totals

# Yaxşi: bitta vektorlaşgan qator
sales["revenue"] = sales["quantity"] * sales["price"]
Agar DataFrame böylab for sikli yozayotgan bölsangiz, avval işni bajaradigan ustun amali, groupby yoki .str/.dt metodini qidiring.
Maşqlar
1. Eng köp sotilgan mahsulot
Quyidagi jadvaldan foydalanib, revenue ustunini qöşing va mahsulotlarni jami daromad böyiça, eng kattasidan boşlab saralab çop eting.
import pandas as pd

sales = pd.DataFrame({
    "product": ["Çoy", "Somsa", "Çoy", "Şarbat", "Somsa", "Şarbat"],
    "quantity": [4, 10, 5, 3, 12, 6],
    "price": [15000, 8000, 15000, 12000, 8000, 12000],
})
Yeçim
import pandas as pd

sales = pd.DataFrame({
    "product": ["Çoy", "Somsa", "Çoy", "Şarbat", "Somsa", "Şarbat"],
    "quantity": [4, 10, 5, 3, 12, 6],
    "price": [15000, 8000, 15000, 12000, 8000, 12000],
})
sales["revenue"] = sales["quantity"] * sales["price"]

print(sales.groupby("product")["revenue"].sum().sort_values(ascending=False))product
Somsa 176000
Çoy 135000
Şarbat 108000
Name: revenue, dtype: int64Guruhlangan natija Series bölgani uçun sort_values() ustun nomisiz işlatiladi.
2. Email domenlari
Katta-kiçik harflarni hisobga olmasdan, har bir email domeniga ega foydalanuvçilar sonini sanang.
import pandas as pd

users = pd.DataFrame({
    "email": ["aziza@Mail.uz", "bekzod@gmail.com", "dilnoza@mail.uz",
              "farrux@GMAIL.com", "nodira@mail.uz"],
})
Yeçim
import pandas as pd

users = pd.DataFrame({
    "email": ["aziza@Mail.uz", "bekzod@gmail.com", "dilnoza@mail.uz",
              "farrux@GMAIL.com", "nodira@mail.uz"],
})

domains = users["email"].str.lower().str.split("@").str[1]
print(domains.value_counts())email
mail.uz 3
gmail.com 2
Name: count, dtype: int643. Guruh hisoboti
Har bir guruh uçun öquvçilar sonini, örtaça bahoni (1 xonagaça yumaloqlangan) va eng yuqori bahoni körsating. Nomlangan agregatsiyalardan foydalaning.
import pandas as pd

results = pd.DataFrame({
    "student": ["Aziza", "Bekzod", "Dilnoza", "Farrux", "Nodira", "Sardor"],
    "group": ["A", "B", "A", "B", "A", "B"],
    "score": [91, 67, 84, 78, 88, 72],
})
Yeçim
import pandas as pd

results = pd.DataFrame({
    "student": ["Aziza", "Bekzod", "Dilnoza", "Farrux", "Nodira", "Sardor"],
    "group": ["A", "B", "A", "B", "A", "B"],
    "score": [91, 67, 84, 78, 88, 72],
})

report = results.groupby("group").agg(
    students=("student", "count"),
    average=("score", "mean"),
    best=("score", "max"),
).round(1)
print(report) students average best
group
A 3 87.7 91
B 3 72.3 784. Mijoz şaharlari bilan buyurtmalar
Har bir buyurtmada mijozning şahri körinadigan qilib ikki jadvalni birlaştiring, keyin har bir şahar böyiça jami xarajatni çop eting. Left mergeʼdan foydalaning va nomaʼlum şaharlarni "Nomaʼlum" bilan töldiring.
import pandas as pd

orders = pd.DataFrame({
    "customer_id": [1, 2, 1, 3, 4],
    "amount": [120000, 45000, 80000, 300000, 60000],
})
customers = pd.DataFrame({
    "customer_id": [1, 2, 3],
    "city": ["Toşkent", "Samarqand", "Toşkent"],
})
Yeçim
import pandas as pd

orders = pd.DataFrame({
    "customer_id": [1, 2, 1, 3, 4],
    "amount": [120000, 45000, 80000, 300000, 60000],
})
customers = pd.DataFrame({
    "customer_id": [1, 2, 3],
    "city": ["Toşkent", "Samarqand", "Toşkent"],
})

merged = orders.merge(customers, on="customer_id", how="left")
merged["city"] = merged["city"].fillna("Nomaʼlum")
print(merged.groupby("city")["amount"].sum())city
Nomaʼlum 60000
Samarqand 45000
Toşkent 500000
Name: amount, dtype: int644-mijozning yozuvi yöq, şuning uçun left merge şahar örniga NaN beradi va fillna() uni almaştiradi.
5. Oylik konveyer
Quyidagi CSV matnini öqiydigan, revenue qöşadigan, faqat Toşkent va Samarqand qatorlarini qoldiradigan, .dt.month bilan month ustunini qöşadigan va qatorlari oylar, ustunlari şaharlar bölgan daromad yiğma jadvalini tuzadigan bitta metodlar zanjirini yozing.
date,city,quantity,price
2026-01-05,Toşkent,4,15000
2026-01-18,Samarqand,10,8000
2026-02-03,Buxoro,5,15000
2026-02-14,Toşkent,12,8000
2026-02-21,Samarqand,6,12000
2026-03-10,Toşkent,7,15000
2026-03-18,Samarqand,2,15000
Yeçim
import io
import pandas as pd

text = """date,city,quantity,price
2026-01-05,Toşkent,4,15000
2026-01-18,Samarqand,10,8000
2026-02-03,Buxoro,5,15000
2026-02-14,Toşkent,12,8000
2026-02-21,Samarqand,6,12000
2026-03-10,Toşkent,7,15000
2026-03-18,Samarqand,2,15000
"""

table = (
    pd.read_csv(io.StringIO(text), parse_dates=["date"])
    .assign(revenue=lambda d: d["quantity"] * d["price"])
    .loc[lambda d: d["city"].isin(["Toşkent", "Samarqand"])]
    .assign(month=lambda d: d["date"].dt.month)
    .pivot_table(index="month", columns="city", values="revenue", aggfunc="sum")
)
print(table)city Samarqand Toşkent
month
1 80000 60000
2 72000 96000
3 30000 105000.loc funksiyani ham qabul qiladi, bu esa zanjir örtasida filtrlaş imkonini beradi. Har bir lambda d: DataFrameʼni aynan şu qadamdagi holatida oladi, şuning uçun month filtrdan keyin qöşilişi mumkin.
Xulosa
- Yangi ustunlar vektorlaşgan hisobdan hosil böladi:
df["revenue"] = df["quantity"] * df["price"];sort_values()qatorlarni saralaydi,value_counts()esa qiymatlarni sanaydi. df.groupby(key)[col].sum()guruhlarni umumlaştiradi. Bir neça natija uçunagg(name=(col, func)), guruh jamilarini har bir qatorga qaytariş uçuntransform(), ğolib yorliq uçunidxmax(), ikki yönalişli hisobot uçunpivot_table()dan foydalaning.drop_duplicates(),rename()vadrop()bilan tozalang; bir xil şakldagi jadvallarniconcat()bilan ustma-ust qöying; kalit böyiçamerge(other, on=key, how=...)bilan birlaştiring (left merge çap jadvalning har bir qatorini saqlaydi)..strva.dtsatr va sana amallarini butun ustunlarga qöllaydi;pct_change()oylik qatorni öşiş surʼatlariga aylantiradi.apply()öz funksiyangizni işga tuşiradi, lekin vektorlaşgan amallar mavjud bölsa, ular soddaroq va tezroq.- Qiymatni
.loc[mask, col] = valuebilan bering, özgartiriladigan qismlar uçun.copy()işlating, şartlarni&va|bilan birlaştiring hamda metodlar qaytargan DataFrameʼlarni saqlang.