

Satrlar
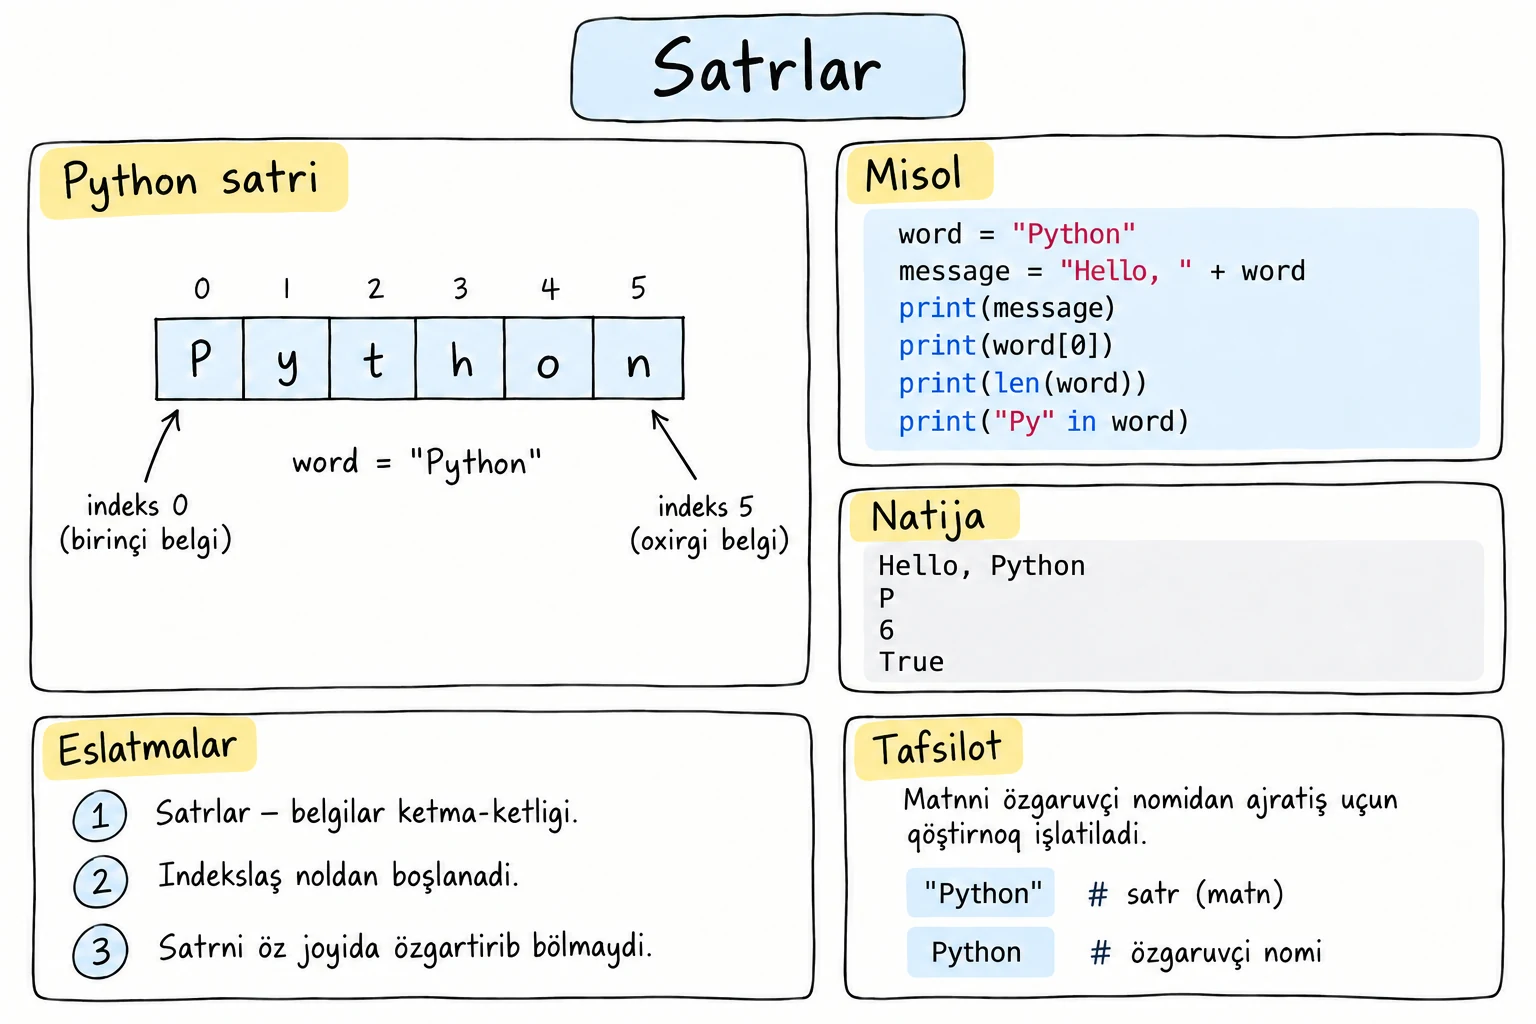
Nimalarni örganasiz
- Satrlarni
+bilan birlaştiriş,*bilan takrorlaş valen()bilan belgilarni sanaş - Python belgilarni Unicode sifatida qanday saqlaydi va
bytesnima - Indekslaş yordamida, jumladan manfiy indekslar bilan, bitta belgini oliş
- Nega satrlarni joyida özgartirib bölmaydi (özgarmaslik)
- Matn içida biror narsa bor-yöqligini
inbilan tekşiriş
Nega bu muhim
Ismlar, xabarlar, elektron xatlar, fayl nomlari, parollar, veb-sahifalar: real hayotdagi maʼlumotlarning juda katta qismi matndan iborat. Pythonda matn satr (string, str) sifatida, yaʼni belgilar ketma-ketligi sifatida saqlanadi. Satrlarni qanday yozişni Salom, dunyo! darsidan bilasiz. Bu dars ularni qanday qismlarga ajratiş va qayta yiğişni körsatadi.
Satrlarni birlaştiriş: +
+ satrlarni bir-birining ketidan ulaydi (birlaştiradi):
first_name = "Aziza"
last_name = "Karimova"

full_name = first_name + " " + last_name
print(full_name)Aziza Karimova+ özi böş joy qöşmaydi, şuning uçun uni yuqoridagi " " kabi özingiz qöşişingiz kerak.
Satrlarni takrorlaş: *
Satrni butun songa köpaytirsangiz, u takrorlanadi:
print("ha" * 3)
print("-" * 20)hahaha
--------------------Bu matnli natijada çiziqlar va ramkalar çiziş uçun tez usul.
Uzunlik: len()
Örnatilgan len() funksiyasi satrda neçta belgi borligini qaytaradi. Böş joylar va tiniş belgilari ham sanaladi:
password = "çoy2go!"
print(len(password))
print(len("Salom, dunyo!"))
print(len(""))7
13
0"" - böş satr, yaʼni birorta ham belgisi yöq satr.
Indekslaş: bitta belgini oliş
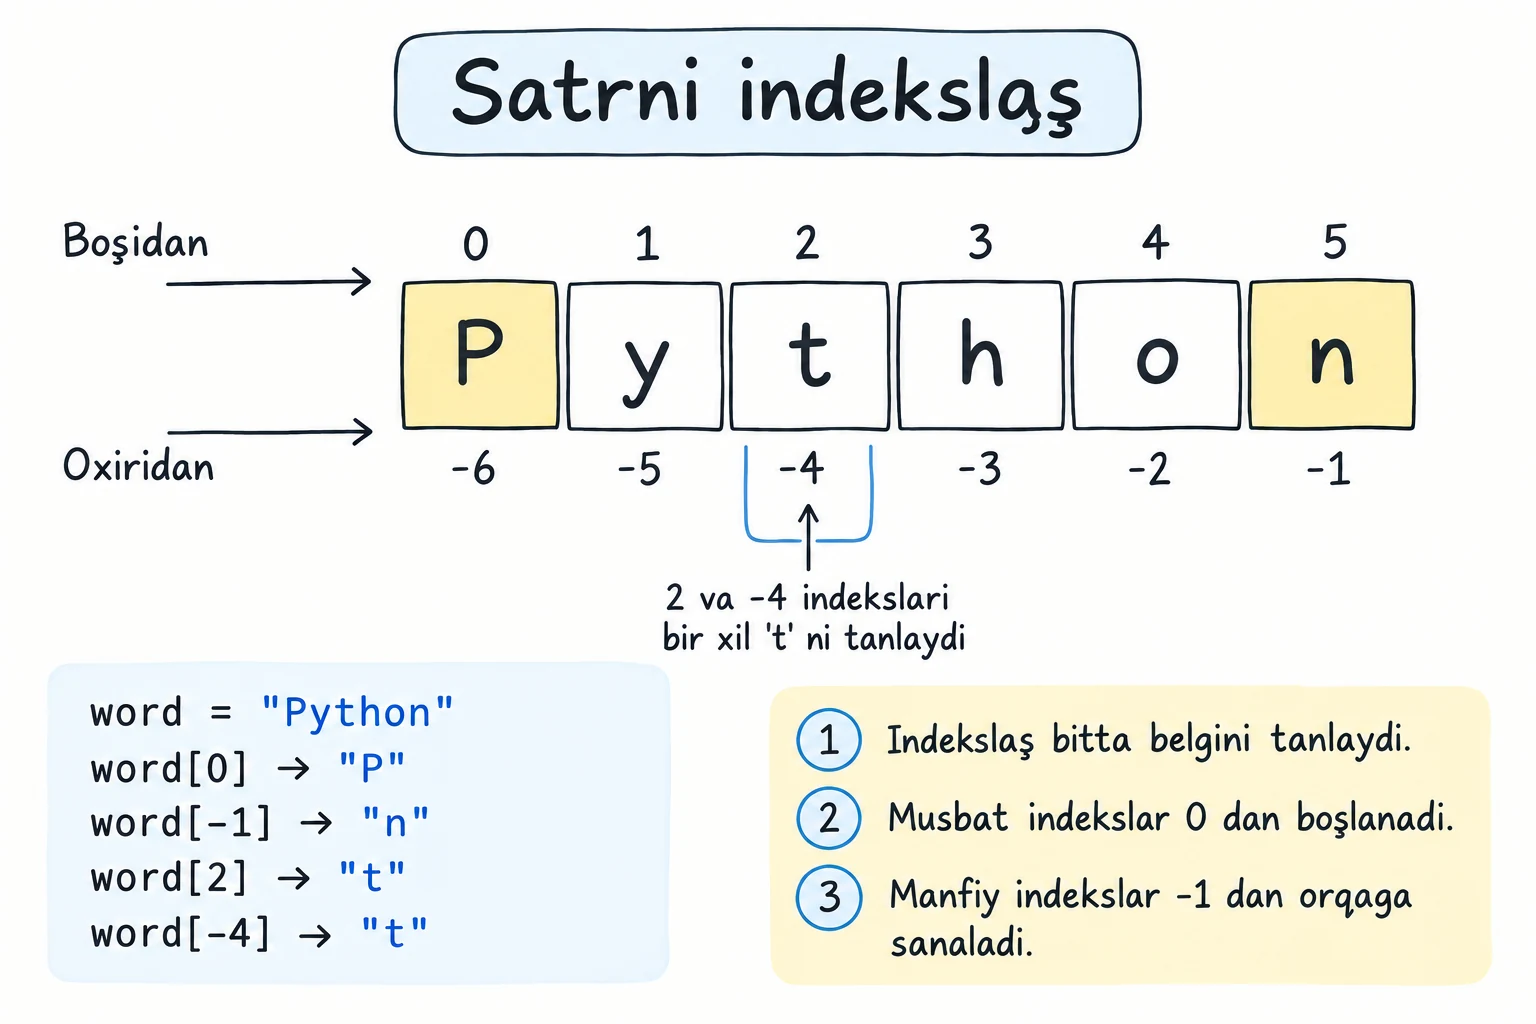
Satrdagi har bir belgining indeks (index) deb ataladigan örin raqami bor. Indekslar 0 dan boşlanadi:
 P   y   t   h   o   n
 0   1   2   3   4   5     ← boşidan hisoblangan indeks
-6  -5  -4  -3  -2  -1     ← oxiridan hisoblangan indeks
Belgini oliş uçun indeksni kvadrat qavs içiga yozing:
word = "Python"

print(word[0])   # birinçi belgi
print(word[1])
print(word[5]) # oxirgi belgiP
y
nManfiy indekslar oxiridan sanaydi
-1 - oxirgi belgi, -2 - oxiridan ikkinçi belgi va hokazo. Bu uzunlikni bilmaganingizda qulay:
word = "Python"
print(word[-1])
print(word[-2])n
oOxirgi indeks doim len(word) - 1 ga teng, çunki sanaş 0 dan boşlanadi:
word = "Python"
print(word[len(word) - 1])   # word[-1] bilan bir xil
Nega 0 dan boşlanadi?
Indeksni "boşidan neçta belgini ötkazib yuboriş kerak" deb tasavvur qiling. Birinçi belgini oliş uçun 0 ta belgini ötkazib yuborasiz. Aksariyat dasturlaş tillari şunday sanaydi va siz bunga tez könikib qolasiz.
Keyingi darsda bir vaqtning özida bir neçta belgini oladigan kesiş (slicing) ni örganasiz (masalan, word[0:3] → "Pyt").
Satrlarni joyida özgartirib bölmaydi
Satrlar özgarmas (immutable): satr yaratilgandan keyin uning belgilarini özgartirib bölmaydi.
word = "salom"
word[0] = "S"TypeError: 'str' object does not support item assignmentXabar "satr obyekti elementga qiymat berişni qöllab-quvvatlamaydi" deydi. Uning örniga yangi satr yaratib, uni özgaruvçiga berasiz:
word = "salom"
word = "S" + word[1:]   # "S" + "alom"
print(word)Salom(word[1:] "1-indeksdan oxirigaça" degani. Kesiş keyingi darsda tuşuntiriladi.)
Özgarmaslik çeklovdek tuyuladi, lekin u satrlarni bemalol ulaşiş imkonini beradi: agar ikki özgaruvçi bitta satrni körsatsa, ularning heç biri uni boşqasi uçun özgartira olmaydi.
Tarkibni tekşiriş: in
in bir satr boşqasining içida bor-yöqligini tekşiradi. Natija True yoki False böladi:
email = "aziza@example.com"

print("@" in email)
print("gmail" in email)
print("gmail" not in email)True
False
TrueTekşiruv katta-kiçik harfni farqlaydi: "Py" in "python" False ga teng. True/False natijalardan Şart operatorlari bölimida if buyruqlari bilan foydalanasiz.
Satrlar va sonlar özidan özi aralaşmaydi
+ sonlar uçun qöşiş, satrlar uçun esa birlaştiriş degani. Ularni aralaştirsangiz, Python nima istaganingizni taxmin qilişdan boş tortadi:
age = 20
print("Yoş: " + age)TypeError: can only concatenate str (not "int") to strXabar "str ga faqat str ni (int ni emas) ulaş mumkin" deydi. Sizda uçta yaxşi variant bor:
age = 20

print("Yoş:", age)          # 1. print() ga alohida argumentlar
print("Yoş: " + str(age))   # 2. sonni str() bilan özgartiriş
print(f"Yoş: {age}")        # 3. f-satr (F-satrlar darsiga qarang)
Uçalasi ham Yoş: 20 ni çiqaradi. Odatda f-satr eng tuşunarlisi va uni tez orada örganasiz.
Matn, Unicode va baytlar
Kompyuter faqat sonlarni saqlaydi, şuning uçun har bir belgining ham soni bor. Python Unicode dan foydalanadi - bu deyarli barça yozuv tizimlaridagi (lotin, kirill, arab, emoji va boşqalar) har bir belgiga kod nuqtasi (code point) deb ataladigan son beradigan standart. ord() belgining kod nuqtasini beradi, chr() esa teskarisini qiladi:
print(ord("A"), ord("ş"))
print(chr(65), chr(351))65 351
A şlen() sizga harfdek körinadigan narsani emas, kod nuqtalarini sanaydi. Özbek lotin yozuvida oʻ o harfi va alohida modifikator harf ʻ bilan yoziladi, şuning uçun u ikkita belgi hisoblanadi:
print(len("oʻ"))
print(len("Oʻzbekiston"))
print(ord("ʻ"), ord("'"))2
11
699 39Oxirgi qator ʻ (kod nuqtasi 699) va klaviaturadagi apostrof ' (39) öxşaş körinsa ham boşqa-boşqa belgilar ekanini körsatadi. Bu matnni qidiriş yoki taqqoslaşda muhim (Köp uçraydigan xatolar ga qarang).
str va bytes
str belgilarni saqlaydi. Matn faylga saqlanganda yoki internet orqali yuborilganda u baytlar (bytes) ga - 0 dan 255 gaça bölgan oddiy sonlarga aylanişi kerak. Belgilarni baytlarga aylantiriş qoidalari kodlaş (encoding) deb ataladi va işlatiş kerak bölgani UTF-8. .encode() satrni bytes ga, .decode() esa qaytadan satrga aylantiradi:
country = "Oʻzbekiston"
data = country.encode("utf-8")

print(data)
print(len(data))
print(data.decode("utf-8"))b'O\xca\xbbzbekiston'
12
Oʻzbekistonbytes qiymati qöştirnoq oldida b bilan körsatiladi. Oddiy lotin harflari bittadan bayt oladi, ʻ esa ikkita (\xca\xbb), şuning uçun baytlar satrdan uzunroq. .encode() ni özingiz kamdan-kam çaqirasiz. U fayllarni öqiş va yozişda muhim. Fayllar va pathlib darsi buni, jumladan nega har doim encoding="utf-8" deb yoziş kerakligini tuşuntiradi.
Özingiz sinab köring
Ism va familiyadan foydalanuvçi nomini yarating: ismning birinçi harfi, butun familiya va töliq ismning uzunligi.
Köp uçraydigan xatolar
1. Indeks çegaradan taşqarida
word = "non"
print(word[3])IndexError: string index out of rangeXabar "satr indeksi çegaradan taşqarida" deydi. "non" ning indekslari 0, 1 va 2. Tuzatiş: oxirgi indeks len(word) - 1 ekanini eslang yoki word[-1] dan foydalaning.
2. Birlaştirişda böş joylarni unutiş
city = "Toşkent"
print("Men yaşaydigan şahar:" + city)   # Men yaşaydigan şahar:Toşkent
Tuzatiş: "Men yaşaydigan şahar: " + city yoki print("Men yaşaydigan şahar:", city).
3. Aslida satr bölgan sonlarni qöşiş
apples = "5"
pears = "5"
print(apples + pears)55Xato yöq, şunçaki notöğri javob: ikkala qiymat ham satr, şuning uçun + ularni birlaştiradi. Bu köpinça input() dan kelgan qiymatlar bilan yuz beradi. Tuzatiş: avval ularni songa aylantiring, Kiritiş va turlarni özgartiriş darsida körsatilganidek: int(apples) + int(pears) 10 beradi.
4. Notöğri apostrof bilan qidiriş
country = "Oʻzbekiston"
print("O'zbekiston" == country)
print("'" in country)False
FalseMatn özbekça ʻ harfi bilan yozilgan, qidiruv esa klaviaturadagi ' apostrofni işlatyapti. Ular öxşaş körinadi, lekin boşqa belgilar. Tuzatiş: ikkala joyda ham bir xil belgidan foydalaning. Maʼlumotingizda ikkalasi ham bölişi mumkin bölsa, avval birini ikkinçisiga almaştiring. .replace() ni keyingi darsda örganasiz.
Maşqlar
1. Salomlaşiş
name = "Bekzod" berilgan. + yordamida Salom, Bekzod! ni çiqaring.
Yeçim
name = "Bekzod"
print("Salom, " + name + "!")
2. Birinçi va oxirgi
word = "Samarqand" uçun birinçi belgini, oxirgi belgini va uzunlikni çiqaring.
Yeçim
word = "Samarqand"
print(word[0])
print(word[-1])
print(len(word))S
d
93. Boş harflar
first = "aziza" va last = "karimova" berilgan. Indekslaş va + yordamida a.k. boş harflarini çiqaring.
Yeçim
first = "aziza"
last = "karimova"
print(first[0] + "." + last[0] + ".")
Keyingi darsda buni A.K. ga aylantiradigan .upper() ni örganasiz.
4. Ramkadagi sarlavha
* va len() yordamida sarlavhani ramka içida çiqaring. Ramka eni matnga avtomatik mos kelsin:
+------------------+
| Python kundaligi |
+------------------+
Sarlavhani özgartirsangiz ham kodingiz işlayverişi kerak.
Yeçim
title = "Python kundaligi"
border = "+" + "-" * (len(title) + 2) + "+"

print(border)
print("| " + title + " |")
print(border)
len(title) + 2 sarlavhaning ikki tomonidagi böş joylarni hisobga oladi.
5. Örtadagi belgi
Sözning örtasidagi belgini çiqaring. Uzunligi juft bölgan söz uçun örtadan keyingi belgini çiqaring. "python" (6 harf → h), "olma" (4 harf → m) va "çoy" (3 harf → o) ni uçta özgaruvçiga saqlang va har birining örtadagi belgisini alohida qatorda çop eting.
Yeçim
word1 = "python"
word2 = "olma"
word3 = "çoy"

print(word1[len(word1) // 2])
print(word2[len(word2) // 2])
print(word3[len(word3) // 2])h
m
o"python":6 // 2 = 3,word1[3]esa"h"."olma":4 // 2 = 2,word2[2]esa"m"."çoy":3 // 2 = 1,word3[1]esa"o".
Oldingi darsdagi butun böliş // har qanday uzunlik uçun butun sonli indeks beradi.
Xulosa
+satrlarni birlaştiradi,*esa takrorlaydi. Böş joylarni özingiz qöşing.len(text)belgilarni, jumladan böş joylarni ham sanaydi.text[i]bitta belgini oladi. Indekslar0dan boşlanadi,-1esa oxirgi belgi.- Satrlar özgarmas: satrni özgartiriş örniga yangisini yarating.
"x" in textsatr bölagi bor-yöqligini tekşiradi va katta-kiçik harfni farqlaydi. Satr va sonni+bilan qöşmang:str(),print()dagi vergullar yoki f-satrdan foydalaning.- Har bir belgi - Unicode kod nuqtasi (
ord/chr),.encode("utf-8")esastrnibytesga aylantiradi.