

Regulyar ifodalar
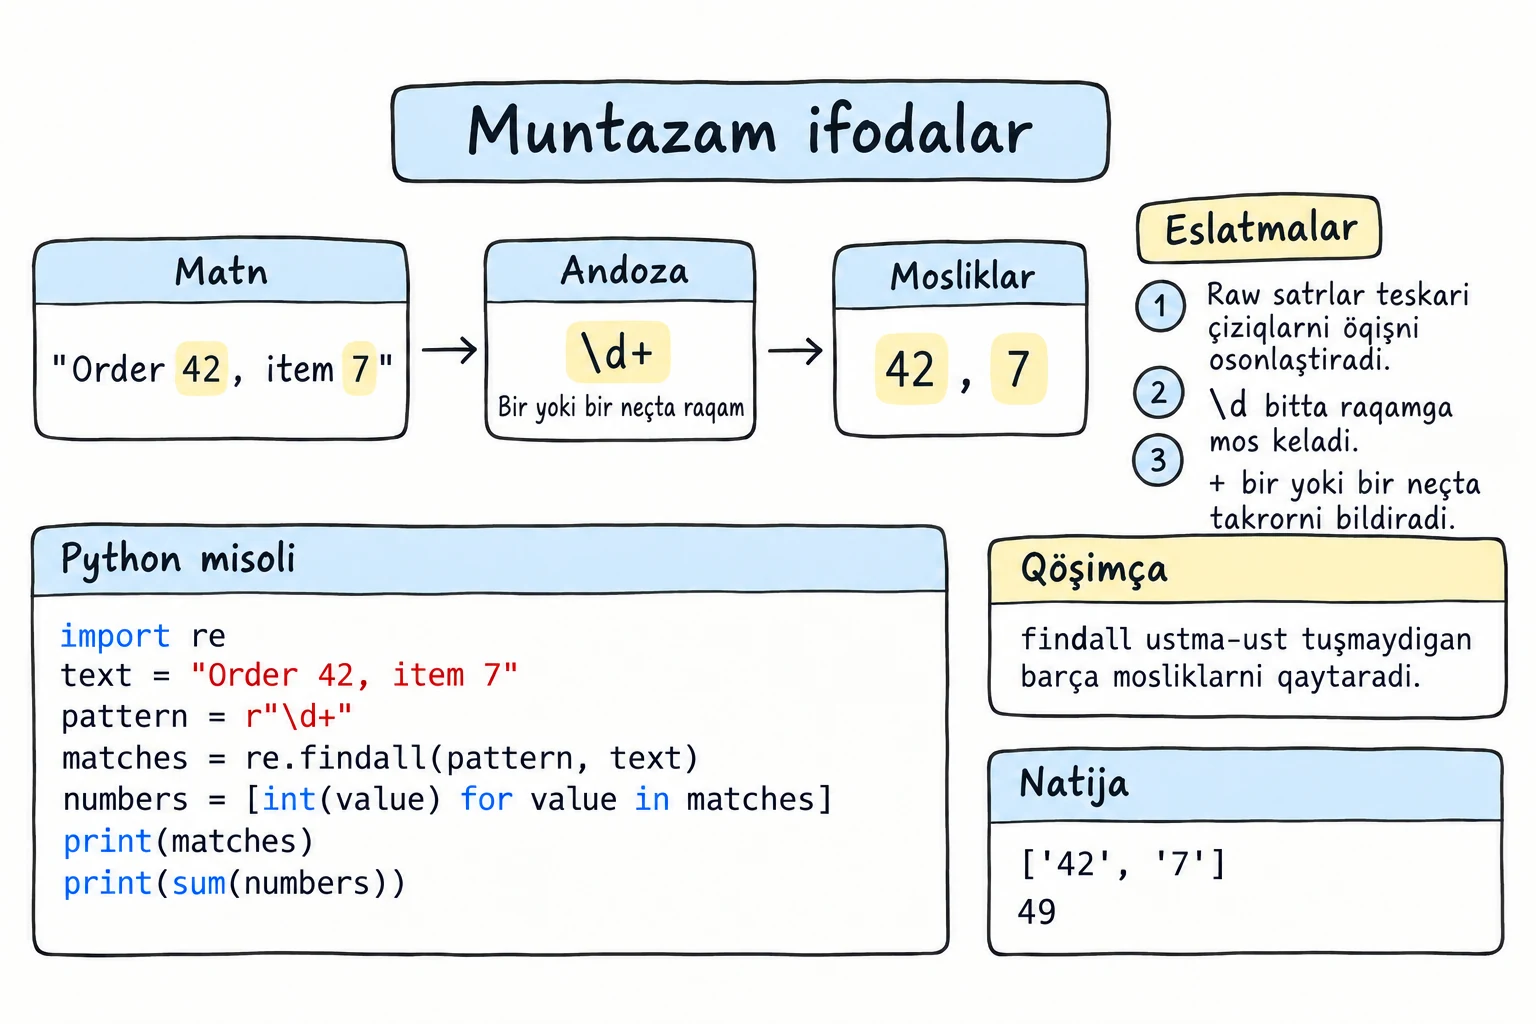
Nimalarni örganasiz
- Qaçon satr metodlari örniga regulyar ifoda işlatiş kerak va nega andozalar xom satr sifatida yoziladi
- Asosiy
refunksiyalari:search,match,fullmatch,findall,finditer,sub,split - Andozalarning tarkibiy qismlari: belgilar sinflari, miqdor belgilari (kvantifikatorlar), langarlar (anchors) va guruhlar
- Guruhga havolalar va funksiyalar bilan almaştiriş, bayroqlar,
re.compilevare.escape - Özbekiston telefon raqamlari, sanalar va narxlar uçun amaliy andozalar
Nega bu muhim
Aytaylik, sizda 5,000 ta mijoz xabari bor va ulardagi barça telefon raqamlarini topiş kerak. Odamlar +998 90 123 45 67, +998901234567 va 90-123-45-67 deb yozadi; find() va split() bilan önlab qator yozasiz va baribir baʼzi holatlarni ötkazib yuborasiz. Regulyar ifoda (regular expression, regex) sizga kerakli matnning şaklini tasvirlaydi: "ixtiyoriy +998, keyin ixtiyoriy böşliqli 9 ta raqam". Regex formalarni tekşirişda, loglarni tahlil qilişda, maʼlumotlarni tozalaşda va köpçilik kod muharrirlarining qidiruv oynasida işlatiladi.
Regex ni öqiş satr metodlariga qaraganda qiyinroq, şuning uçun işni bajaradigan eng oddiy vositani tanlang: belgilangan matn uçun satr metodlari ("error" in text, name.endswith(".csv")), andoza uçun esa regex ("bir neçta raqam", "kk.oo.yyyy körinişidagi sana").
Birinçi andozangiz
Hamma narsa re modulida joylaşgan. re.search(pattern, text) andoza mos keladigan birinçi joyni qidiradi:
import re

message = "5012-buyurtma Buxoroga yetkazildi"

match = re.search(r"\d+", message)
if match:
    print("Topildi:", match.group())
print("Örni:", match.start(), "dan", match.end(), "gaça")Topildi: 5012
Örni: 0 dan 4 gaça\d "raqam", + esa "bir yoki köp" degani. re.search biror narsa topsa match obyektini, aks holda None ni qaytaradi, şuning uçun natijani işlatişdan oldin har doim tekşiring.
Xom satrlar: r"..."
Regex teskari çiziqdan köp foydalanadi, lekin oddiy satrlarda ham teskari çiziqning öz maʼnosi bor (\n - yangi qator, \b - backspace). Qöştirnoq oldidan r yozilgan xom satr (raw string) har bir teskari çiziqni aynan yozilganidek saqlaydi. Usiz Python 3.12+ özi bilmaydigan "\d" kabi escape ketma-ketliklar haqida ogohlantiradi:
SyntaxWarning: "\d" is an invalid escape sequence. Such sequences will not work in the future. Did you mean "\\d"? A raw string is also an option."\b" kabi maʼlum escape lar esa umuman ogohlantiriş bermaydi va andozani jimgina buzadi (Köp uçraydigan xatolarga qarang). Andozalarni har doim xom satr qilib yozing.
re funksiyalari
| Funksiya | Nima qiladi | Qaytaradi |
|---|---|---|
re.search(p, s) | istalgan joydagi birinçi moslik | match yoki None |
re.match(p, s) | faqat boşidagi moslik | match yoki None |
re.fullmatch(p, s) | butun satr mos kelişi kerak | match yoki None |
re.findall(p, s) | barça mosliklar | satrlar röyxati (2+ guruh bölsa kortejlar) |
re.finditer(p, s) | barça mosliklar, birma-bir | match obyektlari iteratori |
re.sub(p, repl, s) | mosliklarni almaştiradi | yangi satr |
re.split(p, s) | mosliklar böyiça böladi | satrlar röyxati |
import re

code = "AB-2026"
print(re.search(r"\d+", code))              # istalgan joyda
print(re.match(r"\d+", code))               # 0-örindan boşlanişi kerak
print(re.fullmatch(r"[A-Z]+-\d{4}", code))  # butun satr

text = "Çoy 15000 söm, somsa 8000 söm"
print(re.findall(r"\d+", text))

print(re.split(r"\s*[,;]\s*", "python, regex;files ; json"))<re.Match object; span=(3, 7), match='2026'>
None
<re.Match object; span=(0, 7), match='AB-2026'>
['15000', '8000']
['python', 'regex', 'files', 'json']Tekşiriş uçun ("butun kiritilgan matn yaroqli kodmi?") fullmatch dan, matn içidan biror narsani topiş uçun esa search, findall yoki finditer dan (match obyektlarini birma-bir beradi, katta matnlar uçun qulay) foydalaning.
Andozaning tarkibiy qismlari
Köpçilik belgilar özlariga mos keladi: a "a" ga mos keladi. Quyidagilarning esa maxsus maʼnosi bor:
| Andoza | Maʼnosi | Misol | Mos keladi |
|---|---|---|---|
. | yangi qatordan boşqa istalgan belgi | m.l | mol, m9l |
^ / $ | satr boşi / oxiri (MULTILINE bilan qator boşi / oxiri) | ^Salom, söm$ | "Salom dunyo", "5000 söm" |
* / + / ? | oldingi elementdan 0 yoki köp / 1 yoki köp / 0 yoki 1 | colou?r | color, colour |
{m} / {m,n} | aynan m ta / m dan n tagaça | \d{2,3} | 12, 123 |
[abc] / [a-z] | töplamdan / oraliqdan bitta belgi | [A-Z0-9] | K, 7 |
[^abc] | töplamda bölmagan bitta belgi | [^0-9] | x, - |
a|b | a yoki b | çoy|qahva | çoy, qahva |
(...) | guruh | (ab)+ | ab, abab |
\d | raqam (istalgan Unicode raqami) | \d\d | 42 |
\w | söz belgisi (harf, raqam, _) | \w+ | Aziza_1 |
\s | böşliq belgisi (böşliq, tab, yangi qator) | a\sb | "a b" |
\D \W \S | raqam / söz belgisi / böşliq EMAS | \S+ | salom! |
\b | söz çegarasi (sözning çeti) | \bçoy\b | "çoy", lekin "çoynak" emas |
\. \+ \? | oddiy . + ? belgisi | \+998 | +998 |
\d istalgan Unicode raqamiga mos keladi (re.fullmatch(r"\d{2}", "١٢") muvaffaqiyatli bajariladi), şuning uçun telefon raqamlari yoki sanalar uçun [0-9] yozing yoki flags=re.ASCII bering.
Miqdor belgilari greedy (iloji boriça köp belgini egallaydi). Ularni non-greedy (iloji boriça kam belgi oladigan) qiliş uçun ulardan keyin ? qöşing:
import re

html = "<b>Toşkent</b> va <b>Samarqand</b>"
print(re.findall(r"<b>.*</b>", html))    # greedy: bitta ulkan moslik
print(re.findall(r"<b>.*?</b>", html)) # non-greedy: ikkita moslik['<b>Toşkent</b> va <b>Samarqand</b>']
['<b>Toşkent</b>', '<b>Samarqand</b>']Guruhlar
Qavslar moslikning qismlarini alohida uşlab oladigan guruhlar hosil qiladi. (?P<name>...) guruhga nom beradi:
import re

m = re.search(r"(\w+): (\d+) ball", "Aziza: 95 ball")
print(m.group(), "|", m.group(1), "|", m.groups())

entry = "2026-09-15 ERROR Tölov amalga oşmadi"
m = re.match(r"(?P<date>\S+) (?P<level>[A-Z]+) (?P<message>.+)", entry)
print(m["level"], m.groupdict())Aziza: 95 ball | Aziza | ('Aziza', '95')
ERROR {'date': '2026-09-15', 'level': 'ERROR', 'message': 'Tölov amalga oşmadi'}findall nima qaytarişi andozadagi guruhlar soniga boğliq:
import re

orders = "çoy 2, qahva 3"

print(re.findall(r"(?:çoy|qahva) \d+", orders))    # guruh yöq: butun mosliklar
print(re.findall(r"(?:çoy|qahva) (\d+)", orders))  # bitta guruh: şu guruh matni
print(re.findall(r"(çoy|qahva) (\d+)", orders)) # bir neçta guruh: kortejlar['çoy 2', 'qahva 3']
['2', '3']
[('çoy', '2'), ('qahva', '3')]Uşlamaydigan guruh (?:...) çoy|qahva ni guruhlaydi, lekin guruh sifatida sanalmaydi, şuning uçun findall natijasini özgartirmaydi.
sub bilan almaştiriş
Almaştiriş satrida \1 (yoki \g<name>) guruh mos kelgan matnni qöyadi. Xuddi şu guruhga havola (backreference) andoza içida ham işlaydi: r"\b(\w+) \1\b" "töla töla" kabi takrorlangan sözni topadi. Satr örniga funksiya ham berişingiz mumkin, sub uni har bir match obyekti bilan çaqiradi:
import re

note = "Menga 901234567 yoki 935556677 raqamiga qönğiroq qiling"
print(re.sub(r"\d{5}(\d{4})", r"*****\1", note))       # oxirgi 4 raqamni qoldiradi

def add_vat(m):
    return f"{int(m.group(1)) * 112 // 100} söm"

print(re.sub(r"(\d+) söm", add_vat, "Çoy 15000 söm, somsa 8000 söm"))Menga *****4567 yoki *****6677 raqamiga qönğiroq qiling
Çoy 16800 söm, somsa 8960 sömAndoza foydalanuvçi kiritgan matndan kelsa, re.escape() undagi maxsus belgilar oldiga teskari çiziq qöyadi: re.escape("5.000 (naqd)") 5\.000\ \(naqd\) ni beradi va bu faqat aynan şu matnga mos keladi.
Bayroqlar va re.compile
re.IGNORECASE harf registrini hisobga olmaydi, re.MULTILINE ^ va $ ni har bir qatorning boşi va oxirida mos keladigan qiladi, re.VERBOSE esa andozadagi böşliqlarni eʼtiborsiz qoldiradi va # izohlarga ruxsat beradi. Bayroqlar | bilan birlaştiriladi:
import re

log = """INFO started
ERROR disk full
error timeout"""

print(re.findall(r"^ERROR (.+)$", log))
print(re.findall(r"^ERROR (.+)$", log, flags=re.MULTILINE | re.IGNORECASE))[]
['disk full', 'timeout']re.compile(pattern) andozani xuddi şu metodlarga ega obyektga aylantiradi (PHONE.fullmatch(text)); Python baribir andozalarni keşlaydi, şuning uçun kompilyatsiya asosan andozaga tuşunarli nom beriş uçun kerak.
Amaliy misol: Özbekiston telefon raqamlari
Özbekiston mobil raqamlari +998, 2 xonali operator kodi va 7 ta raqamdan iborat. Bu batafsil (verbose) andoza ixtiyoriy +998 va ixtiyoriy böşliq yoki çiziqçalarni qabul qiladi, keyin raqamni yagona körinişga keltiradi:
import re

PHONE = re.compile(r"""
    (?:\+?998[\s-]?)?     # ixtiyoriy mamlakat kodi
    ([0-9]{2})[\s-]?      # operator kodi, masalan 90
    ([0-9]{3})[\s-]?      # 123
    ([0-9]{2})[\s-]?      # 45
    ([0-9]{2})            # 67
""", re.VERBOSE)

for s in ["+998 90 123 45 67", "998-93-555-66-77", "90 123 45 67", "12345"]:
    m = PHONE.fullmatch(s)
    if m:
        print(f"{s:<20} -> +998 {' '.join(m.groups())}")
    else:
print(f"{s:<20} -> notöğri")+998 90 123 45 67 -> +998 90 123 45 67
998-93-555-66-77 -> +998 93 555 66 77
90 123 45 67 -> +998 90 123 45 67
12345 -> notöğriŞakl töğriligi - haqiqiylik degani emas
Andoza faqat şaklni tekşiradi. r"([0-9]{2})\.([0-9]{2})\.([0-9]{4})" 31.02.2026 ni ham qabul qiladi, şuning uçun mavjud bölmagan sanalarni rad etiş uçun fullmatch dan keyin guruhlarni int() bilan songa aylantirib, try/except ValueError içida datetime(year, month, day) ga bering. \. ga eʼtibor bering: ekranlanmagan . 15/09/2026 ni ham qabul qilgan bölardi.
Özingiz sinab köring
Matnni yoki andozalarni özgartiring va nima ajratib olinişini köring.
Köp uçraydigan xatolar
1. Xom satrni unutiş
import re

print(re.findall("\bsöm\b", "5000 söm"))    # \b backspace belgisiga aylandi
print(re.findall(r"\bsöm\b", "5000 söm"))[]
['söm']Xato yöq, şunçaki jimgina notöğri natija. Tuzatiş: andozalarni har doim r"..." qilib yozing.
2. search nazarda tutilganda match dan foydalaniş
import re

text = "Jami: 45000 söm"
print(re.match(r"\d+", text))     # None: matn raqam bilan BOŞLANMAYDI
print(re.search(r"\d+", text))None
<re.Match object; span=(6, 11), match='45000'>Tuzatiş: matn içidan qidiriş uçun search işlating. match faqat boşini tekşiradi va "123abc" da ham muvaffaqiyatli böladi; tekşiriş uçun fullmatch dan foydalaning.
3. Match natijasini None ga tekşirmasdan işlatiş
import re

m = re.search(r"\d+", "bu yerda son yöq")
print(m.group())AttributeError: 'NoneType' object has no attribute 'group'Tuzatiş: m.group() ni çaqirişdan oldin if m: yozing.
4. Ekranlanmagan + yoki .
import re

re.search(r"+998", "+998901234567")re.PatternError: nothing to repeat at position 0+ ga takrorlanadigan nimadir kerak. (Python 3.13 dan oldin bu xato re.error deb atalardi, bu nom hamon işlaydi.) Ekranlanmagan . esa jimgina xato qiladi: r"mail.uz" "mailXuz" ga ham mos keladi. Tuzatiş: oddiy belgilarni ekranlang: r"\+998", r"mail\.uz" yoki re.escape() dan foydalaning.
Maşqlar
1. Barça yillarni toping
"1998 yilda qurilgan, 2015 va 2023 yillarda taʼmirlangan, 150 ta xona" matnidan barça 4 xonali sonlarni butun son sifatida ajratib oling.
Yeçim
import re

text = "1998 yilda qurilgan, 2015 va 2023 yillarda taʼmirlangan, 150 ta xona"
years = [int(y) for y in re.findall(r"\b\d{4}\b", text)]
print(years)[1998, 2015, 2023]Ikki tomondagi \b uzunroq sonning birinçi tört raqamiga mos kelişning oldini oladi.
2. Heşteglar
"#Samarqand va #Buxoro ga sayohat! #sayohat_2026 #uz" dan barça heşteglarni (# siz) ajratib oling.
Yeçim
import re

post = "#Samarqand va #Buxoro ga sayohat! #sayohat_2026 #uz"
print(re.findall(r"#(\w+)", post))['Samarqand', 'Buxoro', 'sayohat_2026', 'uz']3. Avtomobil raqami tekşiruvçisi
Özbekistondagi xususiy avtomobil raqamlari 01 A 123 BC körinişida böladi: 2 ta raqam, 1 ta harf, 3 ta raqam, 2 ta harf. Ularni böşliqli ham, böşliqsiz ham qabul qiladigan is_valid_plate(text) ni yozing va "01 A 123 BC", "10B456CD", "01 A 12 BC" va "1 A 123 BC" bilan sinab köring.
Yeçim
import re

PLATE = re.compile(r"\d{2} ?[A-Z] ?\d{3} ?[A-Z]{2}")

def is_valid_plate(text):
    return PLATE.fullmatch(text) is not None

for plate in ["01 A 123 BC", "10B456CD", "01 A 12 BC", "1 A 123 BC"]:
print(f"{plate:<12} {is_valid_plate(plate)}")01 A 123 BC True
10B456CD True
01 A 12 BC False
1 A 123 BC False4. Nomlangan guruhlar bilan log xulosasi
Bu logning har bir qatoridan nomlangan guruhlar bilan time, user va amount ni ajratib oling va har bir foydalanuvçining jami summasini çiqaring.
09:15 user=aziza paid=15000
09:20 user=bekzod paid=8000
10:02 user=aziza paid=22000
Yeçim
import re

log = """09:15 user=aziza paid=15000
09:20 user=bekzod paid=8000
10:02 user=aziza paid=22000"""

pattern = re.compile(r"(?P<time>\d{2}:\d{2}) user=(?P<user>\w+) paid=(?P<amount>\d+)")

totals = {}
for m in pattern.finditer(log):
    user = m["user"]
    totals[user] = totals.get(user, 0) + int(m["amount"])

for user, total in totals.items():
print(f"{user}: {total:,} söm")aziza: 37,000 söm
bekzod: 8,000 söm5. Sana formatini özgartiruvçi
Matndagi har bir kk.oo.yyyy sanani topib, uni yyyy-oo-kk körinişida qayta yozadigan, qolgan hamma narsani özgarişsiz qoldiradigan to_iso(text) ni yozing. Almaştirişda nomlangan guruhlar (\g<name>) bilan re.sub dan foydalaning.
Yeçim
import re

DATE = re.compile(r"\b(?P<day>\d{2})\.(?P<month>\d{2})\.(?P<year>\d{4})\b")

def to_iso(text):
    return DATE.sub(r"\g<year>-\g<month>-\g<day>", text)

note = "Imtihon 20.06.2026 da, natijalar 01.07.2026 gaça. Xona 3.14."
print(to_iso(note))
assert to_iso("sanalar yöq") == "sanalar yöq"Imtihon 2026-06-20 da, natijalar 2026-07-01 gaça. Xona 3.14.\g<name> almaştirişga nomlangan guruhni qöyadi. 3.14 özgarmaydi, çunki unda töliq sana şakli yöq.
Xulosa
- Belgilangan matn uçun satr metodlaridan, şakllar uçun esa har doim xom satr bilan yozilgan regex dan foydalaning:
r"\d+". searchistalgan joydan topadi,matchboşini tekşiradi,fullmatchbutun satrni tekşiradi;findall,finditer,subvasplitköp mosliklar bilan işlaydi.- Miqdor belgilari greedy (non-greedy qiliş uçun
?qöşing); oddiy.,+,?ni ekranlang yokire.escapedan foydalaning. (...)va(?P<name>...)guruhlari qismlarni uşlaydi;findallnol yoki bitta guruhda satrlar, köproq guruhda kortejlar qaytaradi.sub\1havolalari yoki funksiyani qabul qiladi;IGNORECASE,MULTILINEvaVERBOSEkabi bayroqlar moslaşni özgartiradi.