

CSV bilan işlaş
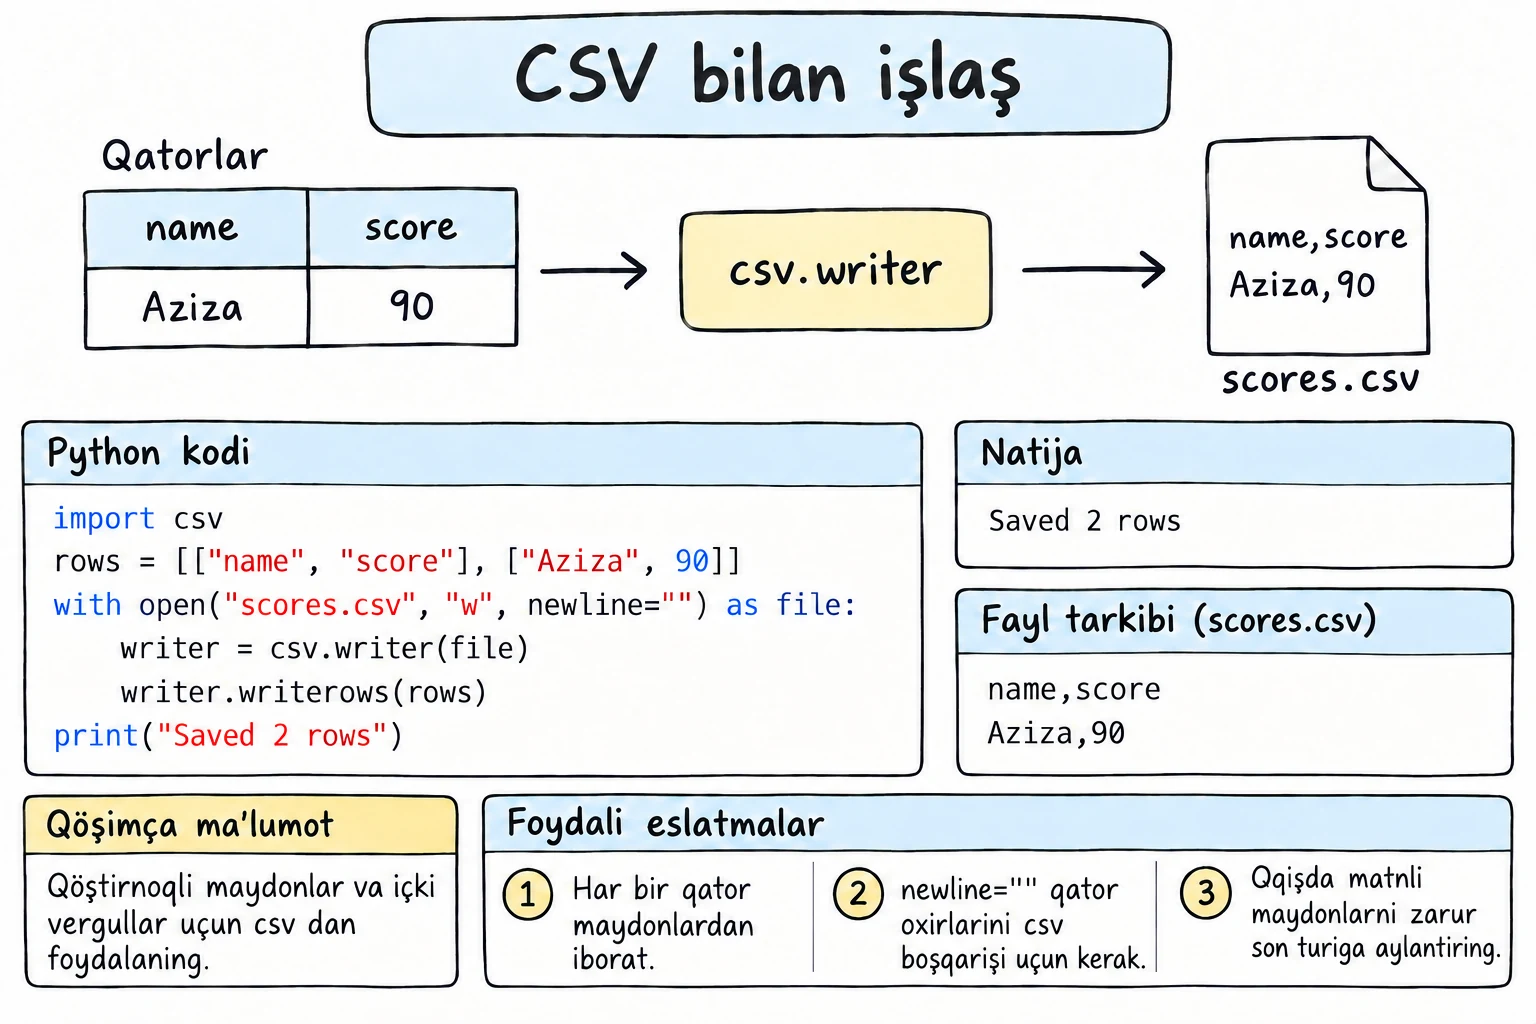
Nimalarni örganasiz
- CSV fayl nima va nega u hamma joyda uçraydi
csv.writervacsv.readerbilan qatorlarni yoziş va öqiş hamda nega fayllarnewline=""bilan oçiladiDictReadervaDictWriterqanday qilib örinlar örniga ustun nomlari bilan işlaş imkonini beradi- Matnli qiymatlarni sonlarga özgartiriş hamda boşqa ajratkiçlar va qöştirnoqli maydonlar bilan işlaş
- Savdo faylini
defaultdictbilan umumlaştiriş
Nega bu muhim
CSV ("comma-separated values", vergul bilan ajratilgan qiymatlar) - jadvalni matnli faylda saqlaşning eng oddiy usuli. Elektron jadvallar uni eksport qiladi, banklar köçirmalarni şu formatda yuboradi, oçiq maʼlumotlar portallari maʼlumotlarni şu formatda eʼlon qiladi. Pythonda CSV bilan elektron jadvallardagi zerikarli işlarni avtomatlaştiriş mumkin: bir oylik savdoni qöşiş, sinf röyxatini tozalaş yoki Excel uçun hisobot tayyorlaş.
CSV fayl qanday körinadi
CSV fayl - oddiy matn: har bir qator - yozuv (row), vergullar maydonlarni (field) ajratadi, birinçi qator esa odatda sarlavha (header):
date,city,product,quantity,price
2026-09-01,Toşkent,çoy,3,15000
2026-09-01,Samarqand,somsa,10,8000
2026-09-02,Toşkent,palov,2,45000
line.split(",") ni sinab köriş mumkin, lekin Daftar, A5 nomli mahsulot-çi? csv moduli bunday holatlarni töğri hal qiladi.
csv.writer bilan qatorlarni yoziş
import csv

rows = [
    ["date", "city", "product", "quantity", "price"],
    ["2026-09-01", "Toşkent", "çoy", 3, 15000],
    ["2026-09-01", "Samarqand", "somsa", 10, 8000],
    ["2026-09-02", "Toşkent", "palov", 2, 45000],
]

with open("sales.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerows(rows)

with open("sales.csv", encoding="utf-8") as file:
print(file.read(), end="")date,city,product,quantity,price
2026-09-01,Toşkent,çoy,3,15000
2026-09-01,Samarqand,somsa,10,8000
2026-09-02,Toşkent,palov,2,45000csv.writer(file) oçiq faylni öraydi. writerow(row) bitta röyxatni bitta qator qilib yozadi, writerows(rows) bir neçta qatorni yozadi, sonlar esa avtomatik matnga aylanadi.
Har doim newline="" işlating
csv moduli öqiydigan yoki yozadigan CSV fayllarni newline="" bilan oçing. Modul qator oxirlarini özi boşqaradi; busiz yangi qatorlarni özgartiriş (Fayllar va pathlib darsiga qarang) Windows da har bir qatordan keyin böş qator qöşib yuboradi. Bu misollardagi kabi faylning matnini şunçaki çop etiş uçun oddiy open() yetarli.
Excel uçun fayllar
Windows dagi Excel fayl maxsus belgi (BOM) bilan boşlanmasa, ʻ kabi UTF-8 harflarini buzib körsatişi mumkin. Excel uçun möljallangan fayllarni uni qöşadigan encoding="utf-8-sig" bilan yozing; "utf-8-sig" bilan öqiş esa uni yana olib taşlaydi.
csv.reader bilan qatorlarni öqiş
csv.reader har bir qatorni satrlar röyxati sifatida beradi, hatto 3 va 15000 ham satr. Hisoblaş uçun keraklilarini özgartiring:
import csv

with open("sales.csv", "w", newline="", encoding="utf-8") as file:
    file.write("date,city,product,quantity,price\n")
    file.write("2026-09-01,Toşkent,çoy,3,15000\n")
    file.write("2026-09-01,Samarqand,somsa,10,8000\n")
    file.write("2026-09-02,Toşkent,palov,2,45000\n")

total = 0
with open("sales.csv", newline="", encoding="utf-8") as file:
    reader = csv.reader(file)
    header = next(reader)            # birinçi qatorni olamiz
    print("Ustunlar:", header)
    for row in reader:               # qolgan qatorlar
        print(row)
        date, city, product, quantity, price = row
        total += int(quantity) * int(price)

print(f"Jami: {total:,} söm")Ustunlar: ['date', 'city', 'product', 'quantity', 'price']
['2026-09-01', 'Toşkent', 'çoy', '3', '15000']
['2026-09-01', 'Samarqand', 'somsa', '10', '8000']
['2026-09-02', 'Toşkent', 'palov', '2', '45000']
Jami: 215,000 sömnext(reader) faqat bitta qatorni öqiydi - sikldan oldin sarlavhani olib qöyişning qulay usuli. Qatorni nomlangan özgaruvçilarga ajratiş kodni tuşunarli qiladi, qatordagi maydonlar soni notöğri bölsa esa darhol ValueError beradi.
DictReader: qatorlar luğat sifatida
row[3] kabi örinlarni öqiş qiyin va ustun qöşilganda ular buziladi. csv.DictReader har bir qatorni sarlavha kalitli luğat sifatida beradi:
import csv

with open("students.csv", "w", newline="", encoding="utf-8") as file:
    file.write("name,group,math,english\nAziza,9A,92,88\nBekzod,9B,75,81\nDilnoza,9A,86,95\n")

with open("students.csv", newline="", encoding="utf-8") as file:
    reader = csv.DictReader(file)
    print(reader.fieldnames)
    for row in reader:
        average = (int(row["math"]) + int(row["english"])) / 2
print(f"{row['name']:<8} {row['group']} {average:.1f}")['name', 'group', 'math', 'english']
Aziza 9A 90.0
Bekzod 9B 78.0
Dilnoza 9A 90.5DictReader sarlavhani özi öqiydi (next() kerak emas), reader.fieldnames esa ustun nomlarini saqlaydi. Qulay andoza: Içma-iç maʼlumotlar darsidagidek barça qatorlarni röyxatga yuklab, turlarni bir marta özgartiriş, şunda dasturning qolgan qismi toza maʼlumot bilan işlaydi.
DictWriter: luğatlarni yoziş
csv.DictWriter ga ustun nomlari (fieldnames) kerak. Bir marta writeheader() ni çaqiring, keyin luğatlarni yozing:
import csv

orders = [
    {"id": 101, "customer": "Aziza", "total": 125000, "city": "Toşkent"},
    {"id": 102, "customer": "Farrux", "total": 48000, "city": "Buxoro"},
]

with open("orders.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["id", "customer", "city", "total"])
    writer.writeheader()
    writer.writerows(orders)

with open("orders.csv", encoding="utf-8") as file:
print(file.read(), end="")id,customer,city,total
101,Aziza,Toşkent,125000
102,Farrux,Buxoro,48000Ustunlar har bir luğatdagi kalitlar tartibiga emas, fieldnames tartibiga amal qiladi. fieldnames da yöq kalit ValueError beradi (uni ötkazib yuboriş uçun extrasaction="ignore" bering). Luğatda yetişmayotgan maydon indamay böş qiymat sifatida yoziladi; restval="nomaʼlum" uning örniga şu matnni yozadi.
Qöştirnoqlar: maydon içidagi vergullar
Qiymat içida vergul bölsa-çi? csv.writer uni avtomatik qöştirnoqqa oladi, csv.reader esa ularni yana olib taşlaydi:
import csv

products = [
    ["name", "price"],
    ["Daftar, A5", 12000],
    ['Ruçka "Klassik"', 3000],
    ["Çoy", 15000],
]

with open("products.csv", "w", newline="", encoding="utf-8") as file:
    csv.writer(file).writerows(products)

with open("products.csv", encoding="utf-8") as file:
    print(file.read(), end="")

with open("products.csv", newline="", encoding="utf-8") as file:
    for row in csv.reader(file):
print(row)name,price
"Daftar, A5",12000
"Ruçka ""Klassik""",3000
Çoy,15000
['name', 'price']
['Daftar, A5', '12000']
['Ruçka "Klassik"', '3000']
['Çoy', '15000']Qöştirnoqli maydon içidagi qöştirnoqlar ikkilanadi (""); csv moduli buni siz uçun bajaradi.
Boşqa ajratkiçlar
Vergul önlik belgi bölgan joylarda (12,5) Excel CSV ni nuqtali vergul bilan saqlaydi. delimiter ni bering:
import csv

with open("prices_eu.csv", "w", newline="", encoding="utf-8") as file:
    file.write("product;price_usd\n")
    file.write("Noutbuk;799,90\n")
    file.write("Siçqonça;12,50\n")

with open("prices_eu.csv", newline="", encoding="utf-8") as file:
    for row in csv.DictReader(file, delimiter=";"):
        price = float(row["price_usd"].replace(",", "."))
print(row["product"], price)Noutbuk 799.9
Siçqonça 12.5Tabulyatsiya bilan ajratilgan fayllar (köpinça .tsv) uçun delimiter="\t" ni işlating.
Faylsiz CSV: io.StringIO
io.StringIO satrni oçiq fayl kabi işlatadi, bu testlar yoki boşqa joydan kelgan CSV matni uçun qulay:
import csv
import io

text = """city,temperature
Toşkent,34
Nukus,38
Samarqand,31
"""

reader = csv.DictReader(io.StringIO(text))
hottest = max(reader, key=lambda row: int(row["temperature"]))
print(hottest["city"], hottest["temperature"])Nukus 38Savdo faylini umumlaştiriş
Haqiqiy vazifa: har bir şahar böyiça jami tuşumni hisoblab, uni istalgan odam elektron jadvalda oça oladigan yangi CSV fayl sifatida saqlaş. collections va itertools darsidagi defaultdict sanaşni sodda qiladi:
import csv
from collections import defaultdict

with open("sales.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["date", "city", "product", "quantity", "price"])
    writer.writerows([
        ["2026-09-01", "Toşkent", "çoy", 3, 15000],
        ["2026-09-01", "Samarqand", "somsa", 10, 8000],
        ["2026-09-01", "Buxoro", "palov", 4, 40000],
        ["2026-09-02", "Toşkent", "palov", 2, 45000],
        ["2026-09-03", "Toşkent", "somsa", 12, 9000],
    ])

revenue_by_city = defaultdict(int)
with open("sales.csv", newline="", encoding="utf-8") as file:
    for row in csv.DictReader(file):
        revenue_by_city[row["city"]] += int(row["quantity"]) * int(row["price"])

with open("city_totals.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["city", "revenue"])
    writer.writerows(sorted(revenue_by_city.items()))

with open("city_totals.csv", encoding="utf-8") as file:
print(file.read(), end="")city,revenue
Buxoro,160000
Samarqand,80000
Toşkent,243000Özingiz sinab köring
Savdo qatorlarini qöşing yoki şahar örniga har bir kun böyiça savdoni hisoblang.
Köp uçraydigan xatolar
1. Satrlar bilan hisoblaş
import csv, io

rows = csv.DictReader(io.StringIO("name,score\nAziza,92\nBekzod,78\n"))
total = sum(row["score"] for row in rows)TypeError: unsupported operand type(s) for +: 'int' and 'str'CSV dagi har bir qiymat - satr. Özgartiring: sum(int(row["score"]) for row in rows). (Saralaşda ham: "100" < "95" True.)
2. Qatorlarni vergul böyiça özingiz böliş
line = '"Daftar, A5",12000'
print(line.split(","))['"Daftar', ' A5"', '12000']Qöştirnoq içidagi vergul nomni ikkiga bölib yubordi. csv.reader esa ['Daftar, A5', '12000'] beradi.
3. DictWriter da notöğri kalitlar
import csv, io

writer = csv.DictWriter(io.StringIO(), fieldnames=["name", "score"])
writer.writerow({"name": "Aziza", "points": 92})ValueError: dict contains fields not in fieldnames: 'points'points kaliti fieldnames da yöq. Ularni moslang yoki ataylab extrasaction="ignore" bering.
Maşqlar
1. Sinf röyxatini yoziş
name,age sarlavhasi hamda Aziza 15, Bekzod 16, Dilnoza 15 bilan class.csv ni yozing. Uni csv.reader bilan qayta öqing va har bir qatorni çop eting.
Yeçim
import csv

with open("class.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["name", "age"])
    writer.writerows([["Aziza", 15], ["Bekzod", 16], ["Dilnoza", 15]])

with open("class.csv", newline="", encoding="utf-8") as file:
    for row in csv.reader(file):
print(row)['name', 'age']
['Aziza', '15']
['Bekzod', '16']
['Dilnoza', '15']2. Örtaça narx
io.StringIO yordamida bu CSV ni DictReader bilan öqing va örtaça narxni çop eting:
product,price
çoy,15000
qahva,32000
şarbat,12000
Yeçim
import csv
import io

text = "product,price\nçoy,15000\nqahva,32000\nşarbat,12000\n"

prices = [int(row["price"]) for row in csv.DictReader(io.StringIO(text))]
print(f"Örtaça narx: {sum(prices) / len(prices):,.0f} söm")Örtaça narx: 19,667 söm3. Filtrlaş va saqlaş
name,city,salary ustunli va yeçimdagi beşta qatorli employees.csv ni yarating. Faqat Toşkentdagi xodimlar va xuddi şu sarlavha bilan tashkent.csv ni yozing, keyin uni çop eting.
Yeçim
import csv

with open("employees.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["name", "city", "salary"])
    writer.writerows([
        ["Aziza", "Toşkent", 9500000],
        ["Bekzod", "Samarqand", 7200000],
        ["Dilnoza", "Toşkent", 11000000],
        ["Farrux", "Buxoro", 6800000],
        ["Kamola", "Toşkent", 8300000],
    ])

with open("employees.csv", newline="", encoding="utf-8") as source:
    reader = csv.DictReader(source)
    with open("tashkent.csv", "w", newline="", encoding="utf-8") as target:
        writer = csv.DictWriter(target, fieldnames=reader.fieldnames)
        writer.writeheader()
        for row in reader:
            if row["city"] == "Toşkent":
                writer.writerow(row)

with open("tashkent.csv", encoding="utf-8") as file:
print(file.read(), end="")name,city,salary
Aziza,Toşkent,9500000
Dilnoza,Toşkent,11000000
Kamola,Toşkent,8300000Içki with taşqisi hali öqib turganda yozadi. reader.fieldnames dan qayta foydalaniş ustunlarni bir xil saqlaydi.
4. Nuqtali vergulli baholar
grades.csv ni nuqtali vergullar bilan yozing: name;math;physics, keyin Aziza;5;4, Bekzod;3;4, Dilnoza;5;5. Uni öqing, average ustunini qöşing va vergulli grades_with_average.csv sifatida saqlang. Natijani çop eting.
Yeçim
import csv

with open("grades.csv", "w", newline="", encoding="utf-8") as file:
    file.write("name;math;physics\nAziza;5;4\nBekzod;3;4\nDilnoza;5;5\n")

rows = []
with open("grades.csv", newline="", encoding="utf-8") as file:
    for row in csv.DictReader(file, delimiter=";"):
        row["average"] = (int(row["math"]) + int(row["physics"])) / 2
        rows.append(row)

with open("grades_with_average.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["name", "math", "physics", "average"])
    writer.writeheader()
    writer.writerows(rows)

with open("grades_with_average.csv", encoding="utf-8") as file:
print(file.read(), end="")name,math,physics,average
Aziza,5,4,4.5
Bekzod,3,4,3.5
Dilnoza,5,5,5.05. Oylik hisobot
date,category,amount ustunli va yeçimda körsatilgan qatorli payments.csv ni yozing (ikki oy davomidagi tölovlar, ulardan birining summasi n/a). Har bir oy (YYYY-MM) uçun nomi böyiça saralangan har bir toifaning jamisini va oyning jamisini çop eting. Summasi yaroqsiz qatorlarni ötkazib yuboring va ular uçun qator raqami körsatilgan ogohlantiriş çop eting.
Yeçim
import csv
from collections import defaultdict

with open("payments.csv", "w", newline="", encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["date", "category", "amount"])
    writer.writerows([
        ["2026-08-02", "oziq-ovqat", 85000],
        ["2026-08-05", "transport", 12000],
        ["2026-08-14", "oziq-ovqat", 140000],
        ["2026-09-01", "oziq-ovqat", 76000],
        ["2026-09-03", "transport", "n/a"],
        ["2026-09-07", "transport", 15000],
    ])

report = defaultdict(lambda: defaultdict(int))

with open("payments.csv", newline="", encoding="utf-8") as file:
    for line_number, row in enumerate(csv.DictReader(file), start=2):
        try:
            amount = int(row["amount"])
        except ValueError:
            print(f"Ogohlantiriş: {line_number}-qatorda summa notöğri {row['amount']!r}")
            continue
        month = row["date"][:7]
        report[month][row["category"]] += amount

for month in sorted(report):
    categories = report[month]
    print(month)
    for category in sorted(categories):
        print(f"  {category:<10} {categories[category]:>8,}")
print(f" {'JAMI':<10} {sum(categories.values()):>8,}")Ogohlantiriş: 6-qatorda summa notöğri 'n/a'
2026-08
oziq-ovqat 225,000
transport 12,000
JAMI 237,000
2026-09
oziq-ovqat 76,000
transport 15,000
JAMI 91,000defaultdict(lambda: defaultdict(int)) har bir yangi oy uçun içki hisoblagiç yaratadi. start=2 fayldagi qator raqamlariga mos keladi, çunki 1-qator - sarlavha.
Xulosa
- CSV fayl - oddiy matndagi jadval; maydon içidagi qöştirnoq va vergullar töğri işlaşi uçun
split(",")emas,csvmodulini işlating. - CSV fayllarni
newline=""vaencoding="utf-8"bilan oçing (Excel uçun"utf-8-sig"). csv.readerröyxatlar,csv.DictReaderluğatlar beradi;csv.writervacsv.DictWriterularni yozadi.- Öqilgan barça qiymatlar satr: ularni
int()yokifloat()bilan özgartiring. - Nuqtali vergulli fayllar uçun
delimiter=";", xotiradagi CSV matni uçunio.StringIO, umumlaştiriş uçundefaultdictni işlating.